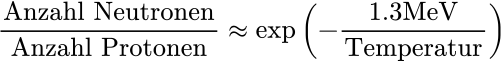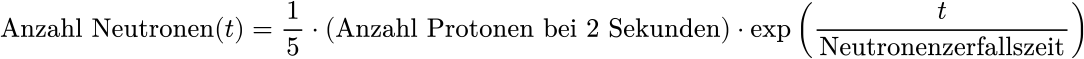Am ersten ordentlichen Tag von Japan II, nach ’nem Sturzregen der mich gehørig durchnaesste (ich habe aber auch schon Schlimmeres erlebt), entdeckte ich nahe des Sees im Ueno Park dieses Schild zum „Boot Feld“ (das ist was da steht):

Offensichtlich darf man dort nur rudern, wenn man schlechte Laune hat … das war also nix fuer mich, denn ich war ganz im Gegenteil (und trotzdem ich ziemlich nass war) bei sehr guter Laune.

2021-04-23 ist das Datum des allerersten Beitrags in dieser Kevin-Bacon-Megamaxiserie. Das Projekt begann aber Monate vorher, denn ich musste ja erstmal darueber nachdenken wie ich die benøtigten Daten aus der Wikipedia herauskitzeln kann. Leider habe ich den Tag des wirklich wahren Anfangs nicht aufgeschrieben; aber 2021-01-08 ist das Datum an dem die Datei mit der dekomprimierten Wikipedia auf meiner Festplatte zum ersten Mal erstellt wurde.

Dem ersten Artikel folgten in der originalen Analyse, mit allen Ablenkungen und Kommentaren und so, 131 weitere Artikel. In der Reproduktionsphase schrieb ich (inklusive diesem hier) ganz genau 50 weitere Beitraege. Zwei abschlieszende (geheime) stehen noch aus … wobei ich mit genauen Zahle diesbezueglich vllt. nicht so voreilig sein sollte. Kevin hat schlieszlich immer wieder gezeigt, dass’s unerwartet mehr wird.

Ich konnte dem inneren Drang alle Wørter zu zaehlen nicht widerstehen. Die nachfolgenden Zahlen sind nicht alle exakt aber zumindest vernuenftig gerundet. Dennoch sind sie vermutlich etwas zu genau ist, denn ich habe nur ’ne grobe Analyse vorgenommen. Vereinfachend gesagt habe ich alle Texte an den Leerzeichen getrennt und dann nur die Anzahl der einzelnen Elemente hergenommen.
Das wiederum bedeutet, das Bindestrichkonstrukte wie „das-ist-ein-Beispiel“ nur als ein Wort zaehlen. Andererseits zaehlt ein “ :) “ auch als ein Wort; ebenso der slash in „foo / bar“. Und Zitate zaehlen die enthaltenden Wørter nocheinmal. Mein Bauchgefuehl sagt mir aber, dass’s insgesamt schon passen sollte. Nu aber Butter bei die Fische.

Alle Zahlen beinhalten auch den vorliegenden Beitrag. Insgesamt brachte ich ungefaehr 168-tausend Wørter in diesen Artikeln zu „Papier“. Das entspricht zwei Erstlingsromanen (die im Durchschnitt ca. 75-tausend Wørter lang sind).
Im Mittel hat ein Artikel 915 Wørter und mit einem Wert von 891 Wørtern hat der Median im Wesentlichen den gleichen Wert. Die Standardabweichung betraegt 421 Wørter.
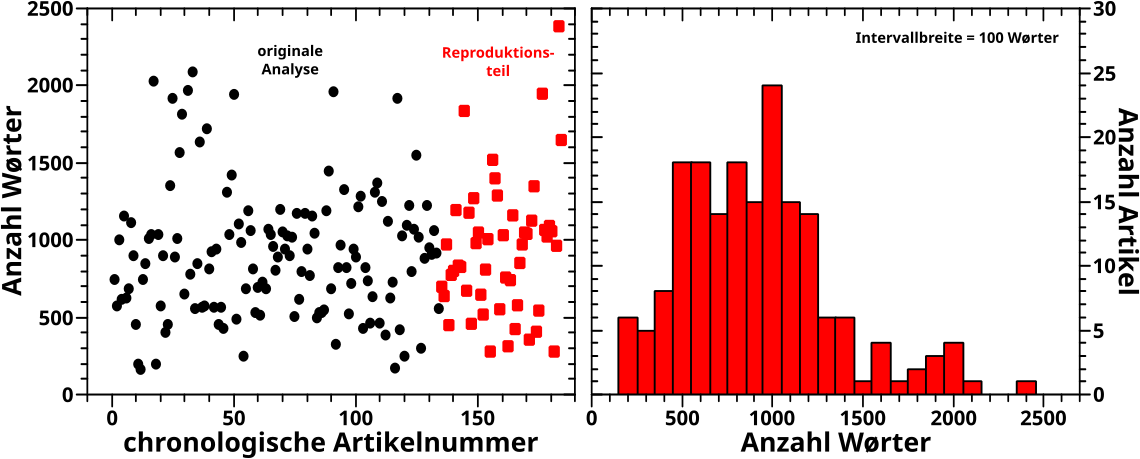
Der Geburtstagsbeitrag vom letzten Mal ist der Høhenrekord mit 2,387 Wørtern, waehrend ich beim Tiefenrekord nur 159 Wørter schrieb (dieser wurde fruehzeitig gesetzt). Zu jeder Zeit kamen immer mal wieder andere Artikel (fast) an diese Zahlen ran … ich habe das (natuerlich) mal diagrammisiert:

Im linken Bild sieht man fuer jeden Artikel die Anzahl der Wørter; farblich kodiert habe ich die zwei Teile des Projekts. Die (Daten)Punkte scheinen sich ziemlich gleichmaeszig zu verteilen auf den ersten Blick. Das wuerde passen mit den recht aehnlichen Werten fuer Durchschnitt und Median. Auf den zweiten Blick hingegen, nachdem man geistig einen Balken um den oben erwaehnten Mittelwert reinlegt, scheint’s dann aber ein paar mehr Punkte unterhalb des Mittelwerts als oberhalb davon zu geben. Deswegen gibt’s das Histogramm dazu auf der rechten Seite.
Die Intervallbreite betraegt 100 Wørter und der „dicke Klotz“ links des 900 Wørter-Balkens macht den Eindruck, dass dort mehr liegt. Von der Anzahl der Artikel ist das tatsaechlich so. Und wuerde man nur 7 Intervalle um den Mittelwert zulassen, dann wuerde das gleiche bzgl. der Wortzahl gelten. Aber die zwølf besonders wortreichen Artikel mit mehr als 1600 Wørtern vereinen ueber 23-tausend Wørter auf sich und das zieht den „Schwerpunkt“ der Wortzahl zu etwas høheren Werten … so funktioniert der Mittelwert halt und ich erwaehnte den Nachteil des darin liegenden Informationsverlust neulich.

Ich schaute mir auch mal die Worthaeufigkeiten an, da kam aber (fast) nix bei rum. Die ueblichen Verdaechtigen sind wie immer ganz oben dabei; also Worte wie „die“ (ca. 5,700 mal), „der“ (ca. 4,500 mal), „das“ (ca. 4.000 mal), „und“ (ca. 3,600 mal), „ist“ (ca. 2,500 mal), „nicht“ (ca. 1,900 mal), „aber“ (ca. 1,900 mal), „dass“ (ca. 1,700 mal) etc. pp.
Das erste interessante das auftritt ist dann auch gar kein Wort sondern das Sonderzeichen “ … “ , welches (inklusive diesem hier) 1,544 mal auftritt. Von weiterem Interesse war das Wort „Seite“ (auch im Zusammenhang wie „Kettenseite“ oder natuerlich „Wikipediaseiten“) und das tritt mehr als 1700 mal auf. Das Wort „Links“ tritt ca. 1000 mal auf. Im Gegensatz dazu erscheinen „Zitate“ (schon zusammen mit den „Zitierungen“ gezaehlt) nur knapp 350 mal. Und als allerletztes sei noch „Linklevel“ erwaehnt, welches ungefaeher 600 mal auftritt.

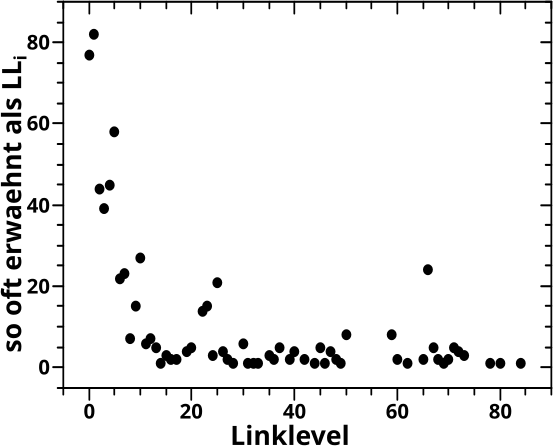
Apropos Linklevel, ich habe hier mal aufgetragen, wie oft die Abkuerzungen LLi in Abhaengigkeit von “ i “ zu sehen sind:

Das ist alles erklaerbar. LL0 & LL1 sind reichlich zu Erklaerungen herangezogen worden. Bis ungefaehr LL10 passiert ziemlich viel und ich habe das oft im Detail untersucht. LL23 tritt so haeufig auf, weil ich das gerne als „zufaelliges“ Linklevel nehme (dito fuer LL5) und LL25 habe ich nicht selten als Grenze fuer „hier-ist-jetzt-definitiv-ein-anderes-Verhalten-als-vorher“ genommen. Wenn ich mich richtig erinnere ist LL66 das Linkevel an dem die ersten Seiten anfangen „auszusteigen“; entsprechend oft wird das genannt worden sein.
Kurios ist die Kluft zwischen LL50 & LL59 … aber da passiert halt nuescht … andererseits passiert auch nuescht zwischen LL25 und LL50 aber dort habe ich trotzdem Datenpunkte … mhmmmmm.
Der einzige Punkt den ich nicht auf Anhieb erklaeren kann, ist LL22. Andererseits tritt das (inklusive diesem hier) dann doch nur 14 mal auf und das ist jetzt in 2 ganzen Romanen die Zeuch auf Linkleveln beschreiben wo irgendwie doch was in dem Bereich passiert (siehe die Bemerkung zu LL25) dann mglw. doch nicht soooo haeufig.

Soweit dazu … das waren aber nur die Wørter in den Artikeln. Dazu kommt noch der Code … das ist aber etwas komplizierter. Am einfachsten ist noch die generelle (zugegeben, oft sehr spezifische) Dokumentation der Programme an sich. Da schrieb ich ca. 48-tausend Wørter … ach du Schreck.
Der Code wird weiter unterteilt in Python und C. Und da gebe ich natuerlich auch die Anzahl der Linien an … weil … das macht man halt so.

Insgesamt sind’s 21,073 Linien von denen 19,081 auf Python und 1,992 auf C entfallen. Davon sind aber insgesamt 9,643 Linien Kommentare (Python: 8,673 / C: 970); das entspricht ca. 45 %. Weitere ungefaher 25 % sind leere Zeilen, damit der Code leichter zu lesen und dessen Struktur besser zu erkennen ist und ueberhaupt, dass es nicht wie Querbeet aussieht; das entspricht 5,426 Linien (Python: 4,968 / C: 458).
Der Rest sind der eigentliche Code und ich komme da insgesamt auf genau 6,004 Linien (Python: 5,440 / C: 564).

Insbesondere auf die nur 564 C-Zeilen bin ich recht stolz. Ich denke, dass das Programm an und fuer sich relativ komplex ist, insb. mit dem was „unter der Haube“ passiert (Zeuch auf das ich an dieser Stelle nie im Detail eingegangen bin) … und ich hab’s trotzdem so klein halten kønnen.
Ueberhaupt zeigt das recht eindrucksvoll, wieviel man aus derart schlanken Programmen herausholen kann, wenn die relativ spezifischen Aufgaben gewidmet sind.

Und nun zur Anzahl der Wørter in den Kommentaren und dem Code an sich. Die Kommentare sind einfach, denn das ist „plain old english“ und im Wesentlichen gelten die gleichen Limitierungen wie zu den Artikeln.
Ich komme insgesamt auf ca. 65-tausend (Python) + ca. 7,500 (C) = ca. 72,500 Wørter insgesamt in den Kommentaren … ach du Schreck. In nicht unbetraechtlichen Teilen ist das nochmal Zeuch was schon in der Dokumentation steht (weil’s zum Verstaendniss der Strukturen und Details im Code beitraegt … hoffe ich). Es beinhaltet aber natuerlich auch sehr viel „operativen Kram“ (wie die Erklaerung warum man in einer Liste das erste Element weglaeszt oder warum eine Schleife nicht ganz bis zum Ende zaehlt etc. pp.) und einfach nur „beschreibenden Text“, der das Lesen und verstehen erleichtern soll.

Beim Code an sich ist das etwas uneindeutiger. Denn viele Zeichen wie “ <= “ oder “ { “ werden als Wort gezaehlt bei meiner einfachen Zaehlweise. Und natuerlich gibt’s urst viele „if“, „then“, „continue“, „for“ etc. pp. und auch einen guten Anteil Zaehlvariablen (meistens einfach nur ein “ i „). Dann wiederum wird sowas wie line.strip().split('\t')[1:] nur als ein einziges „Wort“ gezaehlt. Wieauchimmer, ich komme auf ca. 22-tausend (Python) + ca. 1,500 (C) = ca. 23,500 Wørter (oder „Wørter“) insgesamt, die sich nur im Code befinden. Das selbe was ich oben zu den Linien im C-Code sagte kønnte ich hier wiederholen … ich denke, dass ich da zu Recht durchaus stolz auf mich sein kann.

Summa summarum betraegt die Anzahl der Wørter im Code und in der Dokumentation ungefaehr 145-tausend. Also zwei weitere Buecher … krass … insb. wenn man bedenkt, dass das was am meisten Spasz macht (der Code an sich, ohne Kommentare oder Dokumentation) davon nur ca. 15 % ausmacht … und der Teil der am meisten Freude brachte (besagter C code) sogar gerade mal nur ein Prozent.

So … nun wird das noch mit den Wørtern in den Weblogartikeln zusammengezaehlt und ich komme auf insgesamt ungefaehr 310-tausend Wørter … krassomat!

Das war’s aber noch nicht … ein bisschen habe ich noch. Das geht aber schnell, denn es handelt sich dabei um die Anzahl der Bilder. Ich erstellte ueber eintausendzweihundert Bilder und Diagramme … wow! Gezeigt habe ich aber weniger als 500, denn ein nicht unbetrechtlicher Teil ist (mehr oder weniger) versteckt in den „bewegten“ Bilder (aber jeder „Frame“ musste ja einzeln erstellt werden).

Und das war er dann jetzt wirklich … der letzte ordentliche Artikel und die letzten Diagramme im groszen Kevin Bacon Projekt, was mich und euch, meinen lieben Leserinnen und Leser, fast 5 1/2 Jahre lange begleitete.

Viel wurde gesehen, viel wurde ausprobiert, viel wurde verstanden, viel wurde geschrieben (s.o.) und oft genug hatte ich keine Lust mehr. Aber ich habe es vollendet und nun ist’s offiziell dann doch vorbei … ich gebe ehrlich zu: endlich. Ich muss auch zugeben, dass’s sich noch nicht „ganz echt“ anfuehlt; ein mir nicht unbekannter „Zustand“, kenne ich das doch vom Diplom und den zwei Doktorgraden. Grosze Projekte haben das vermutlich so an sich.

Ganz im Geiste des Kevin Bacon Projektes kommt natuerlich doch noch was. Naemlich die zwei erwaehnten (immer noch) geheimen Artikel. Die sind aber nix „handfestes“ mehr, dort wird nix analysiert, modelliert, simuliert oder kommentiert und Diagramme gibt’s darin auch nicht.

Aber weil das der letzte „richtige“ Artikel ist, møchte ich sagen: toll war’s! Ich habe so viel gelernt und ich bin froh, dass ich damals Ende 2020 die Idee hatte mir das mal anzuschauen … auch wenn ich dachte, dass ich das ganze in ca. 6 Artikeln abarbeiten kann … tja … so kann man sich taeuschen … aber die „Taeuschung“ war gut, denn ich (als Søren) fuehle mich durch das Kevin Bacon Projekt tatsaechlich bereichert.

Beim letzten Mal legte ich dar, dass die Entstehung von Deuterium erst ca. 360 Sekunden nach dem Urknall beginnen konnte, mehr als die Haelfte der Halbwertszeit des Neutrons.

Und da war’s, das VERDAMMT (!!!) knappe Ding.

Das Universum ist 13.7 Milliarden … *nachschlag, denn diese Zahl hab ich von vor 20 Jahren noch im Kopf* … das Universum ist 13.8 Milliarden Jahre alt (Tabelle 4 auf Seite 32, falls ihr, meine lieben Leser und Leserinnen nicht den ganzen Artikel lesen wollt). Das sind ungefaehr 4 × 10¹⁷ Sekunden. Am Anfang hatte das Universum ca. 2 × 4 × 102 Sekunden um was mit den vorhandenen Neutronen zu machen. Das ist ein Faktor von einer Billiarde! Von heute aus gesehen entspricht das VERDAMMT viel weniger als dem Bruchteil einer Sekunde.
Die Haelfte dieses beinahe instantanen Momentchens verbrachte der Kosmos damit „Daeumchen“ zu drehen und den Neutronen beim verschwinden zuzusehen, bevor er sich dachte dann doch endlich mal anzufangen was zu erschaffen, das die Existenz von Dingsbumsen erlaubt, welche die Eleganz der Schøpfung zu erkennen vermøgen.

Das eigentlich Verwunderliche ist also eher, dass’s uns ueberhaupt gibt. Haette das Universum doppelt so lange gebraucht um sich genuegend abzukuehlen, waeren von den urspruenglichen 20 Neutronen pro 100 Protonen weniger als 9 uebrig gewesen. Unser Universum wuerde deutlich anders aussehen in diesem Fall und die Frage steht im Raum ob buchstaeblich genuegend Material vorhanden gewesen waere, um in der „Lotterie der Existenz“ genuegend „Ziehungen“ zu erlauben, in welcher eine unglaublich unwahrscheinliche Kombination von vielen, in richtiger Reihenfolge geschehenden, zufaelligen Ereignissen „gezogen“ wird, welche die besagten, die Schønheit eben dieser Existenz bewusst wahrnehmenden, Dingsbummens zur Folge hat. .oO(Was fuer ein Satz.)
Und damit meine ich nicht unbedingt Leben an sich. Das ist mglw. gar nicht sooo selten anzutreffen. Aber waehrend die Dinosaurier hochentwickeltes Leben waren, deutet nichts darauf hin, dass sie eine Quantenfeldtheorie, Thermodynamik oder (wissenschaftliche!) Kosmologie entwickelt haben, welche das Erkennen eben dieser glorreichen Pracht erst ermøglicht. Ganz zu schweigen davon, dass jede Form von „høherem“ Leben erst sehr spaet auftauchte und viel einfacheres Zeuch wie Bakterien und Archaee die Erde fuer 3/4 der Weltgeschichte beherrschten.

Wie der Titel sagt: It’s a ginormous number’s game …  and we won … wenn man die Existenz eines „Hand anlegenden Schøpfers“ aussschlieszt. Und einige wichtige Parameter dieses „Spiels“ sind von einem URST krass kurzen (VIIIIIEEEEEL weniger als ein) Augenblick in der Geschichte des Universums abhaengig.

Man kann das Ganze auch andersrum aufziehen. Nach zwei Sekunden hatte das Universum die Møglichkeit „was zu tun“ … es musste aber erstmal 200 Mal aelter werden, bevor es was getan hat. Und dann hatte es nur noch ’n Faktor zwei Zeit das was Getan werden muss, auch zu tun.

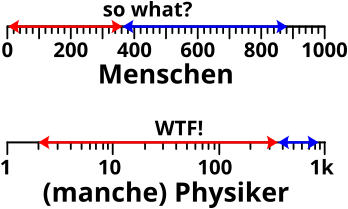
Als Menschen nehmen wir alles in linearen Abstaenden wahr; da sind 2 Sekunden zu 360 Sekunden zu 880 Sekunden jetzt kein „groszes Ding“. Manche Schueler essen zum Anfang der Abiturphysikpruefung eben erstmal gemuetlich Fruehstueck, fangen als letzte an zu schreiben und geben trotzdem als erstes ab. Man muss ja nicht immer die vollen 6 Stunden fuer etwas brauchen, manchmal reicht auch die Haelfte der Zeit.

Aber als Physiker hab ich mich in ueber zwei Jahrzehnte geringfuegig daran gewøhnt Dinge in Grøszenordnungen zu sehen und nicht nur intellektuell zu verstehen, sondern auch ein ganz klein bisschen ein Bauchgefuehl dafuer zu bekommen was das eigentlich bedeutet. Als Bild:

Und deswegen ist ein Faktor 200 (ueber zwei Grøszenordnungen) zu einem Faktor 2 (was normalerweise als „unter ferner liefen“ angesehen wird) eben doch ’n groszes … bzw. VERDAMMT (!!!) knappes Ding.

Geburtstagsbeitrag! Das heiszt wie immer, dass ich ueber Zeuch schreibe ueber das ich gerne schreiben will und mich dabei nicht an meine eigenen Regeln fuer Beitraege halte.

Hier schrieb ich (etwas uebermuetig):

[…] es folgt noch ein Artikel in dem ich die Reproduktion aus einer Metaperspektive kommentiere, ein Artikel der sich die „Metastatistik“ mal anschaut und ein Abschluss … oder vielmehr zwei, die bleiben aber beide noch geheim.

Dieser Beitrag gehørt nicht zu den Genannten … denn wie ich so schøn beim letzten Mal bemerkte:

Tja … wenn mir Kevin eine Sache nahe gebracht hat, dann dass immer alles viiiiiiiieeeeeeeel laenger dauert, weil er mit noch was anderem Spannendem um die Ecke kommt.

Hehe

Fuer den erwaehnten Statistikbeitrag bin ich nochmal durch alle Bilder gegangen und dabei sind mir ein paar wenige aufgefallen, die mir besonders am Herzen liegen. Weil in denen so viel von diesem Projekt, den dazu gehørenden Geschichten und irgendwie auch von mir steckt. Deswegen dachte ich mir: .oO(was fuer eine gute Idee fuer einen Geburtstagsbeitrag, da kann ich die mal alle auf einmal zeigen).

Und das ist mein Geschenk von mir an mich.Aus naheliegenden Gruenden halte ich mich heute nicht an die ansonsten ziemlich strikte „maximal-5-Bilder-pro-Beitrag“ Regel. Ebenso werde ich keine Links zu den Artikeln setzen, in denen die Bilder im Zusammenhang urspruenglich erschienen … nicht weil ich zu faul bin, sondern weil ich die besagten Illustrationen hier in einem anderen Licht praesentieren møchte.

Los geht’s gleich mit dem irgendwie wichtigsten Bild:
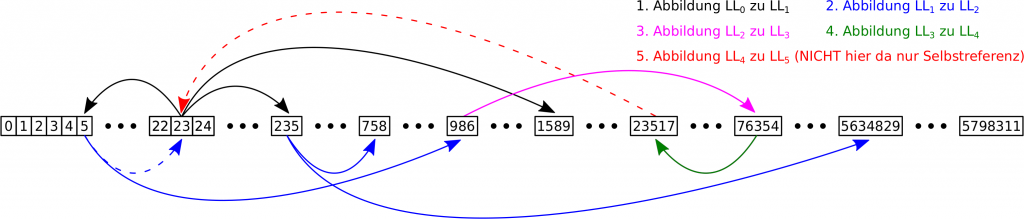
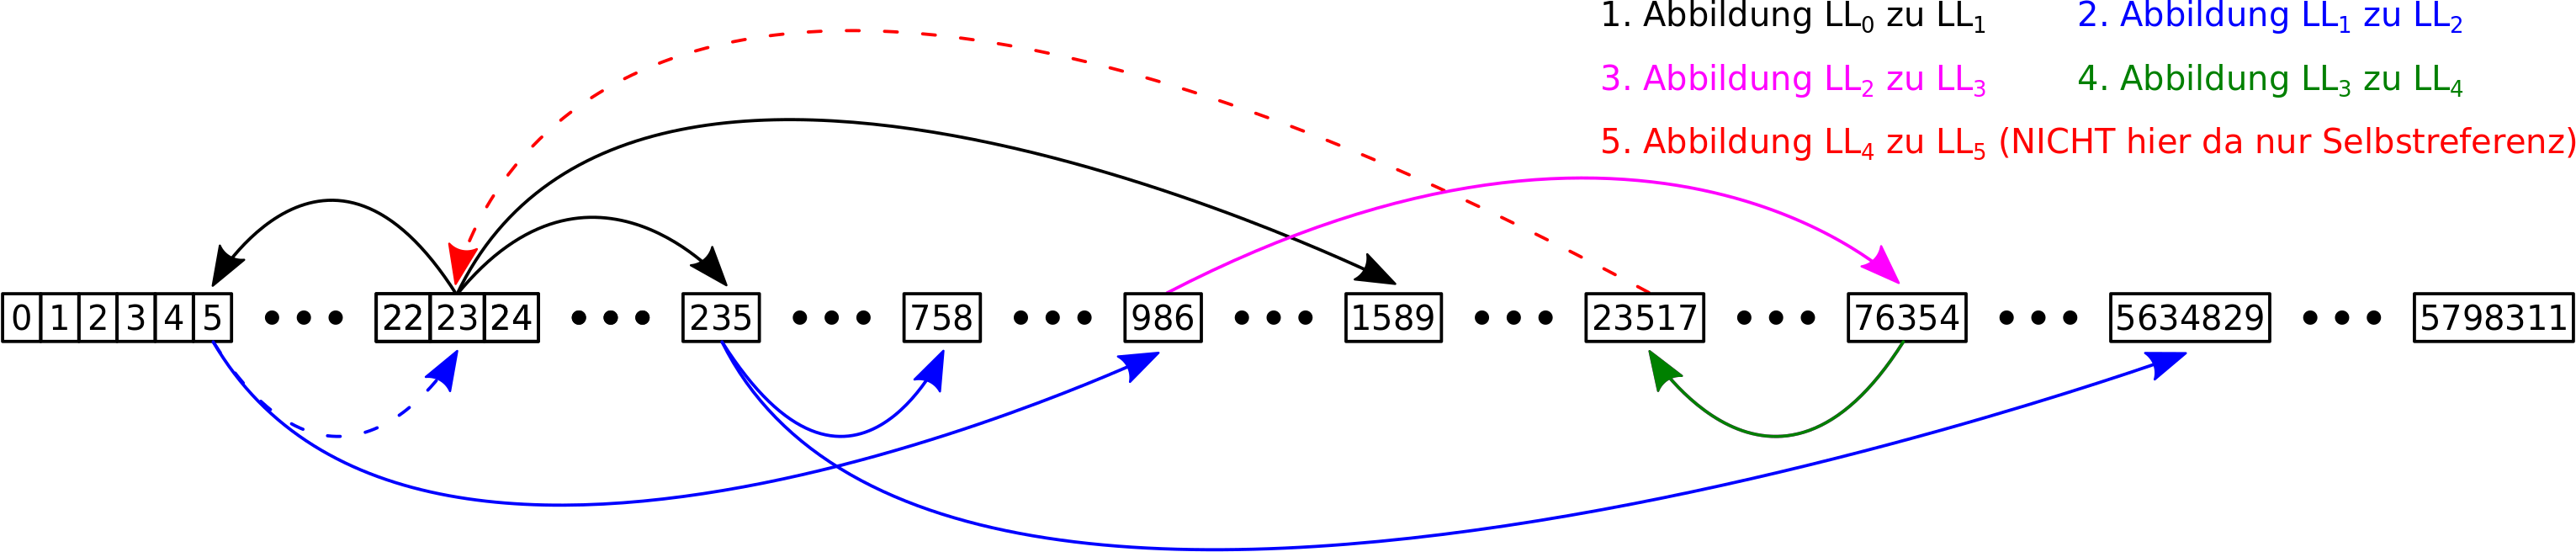
Das Bild liegt mir am Herzen, denn es verkørpert im Wort- und im uebertragenen Sinne, einen meiner (intellektuell und emotional so kostbaren) Heureka! Momente. Ich erzaehlte das Folgende sicher bereits, aber die Geschichte ist so schøn.

Tagelang liesz es mir keine Ruhe wie man algoritmisch effizient das „Abschreiten“ des Wikipedia Linknetzwerkes realisieren kønnte. Viele Stunden dachte ich darueber nach. Ich hatte zwar schon ’nen Algoritmus im Kopf, von dem war mir aber klar, dass der viel zu langsam fuer das Gesamtproblem ist.
Ein wichtiger Meilenstein auf dem Weg zum Durchbruch war die Umwandlung der Artikeltitel in (fortlaufende) Zahlen. Aber das war’s noch nicht ganz … und dann, eines schønen Nachmittags auf dem Fahrrad sitzend und gruebelnd den Weg von der Arbeit nach Hause radelnd, stieg da nicht langsam, aber auch nicht schlagartig, sondern durchaus bemerkbar, die Erkentnis in mir auf, dass die Links ja eine Abbildung sind … und ich wurde ganz hibbelig, denn ich fuehlte, dass mir da was Wichtiges auf der Zunge liegt. Aber worauf bilden die Links ab? … Und dann war er (dann doch schlagartig) da! Der Heureka! Moment — die bilden die Wikipedia auf sich selber ab! … WOOHOO! … Und das ist das was das Bild ganz konkret darstellt. Ich drehte die Idee viele Male in meinem Kopf hin und her wie so eine Abbildung auf sich selber wohl aussieht und in Code gefasst werden kønnte … aber die grundlegende Idee war da und in dem Moment war mir klar, dass ich eine Chance habe das alles wirklich zu analysieren.

Apropos Code, das naechste Bild verkørpert den eben erwaehnten konkreten Code fuer mich:
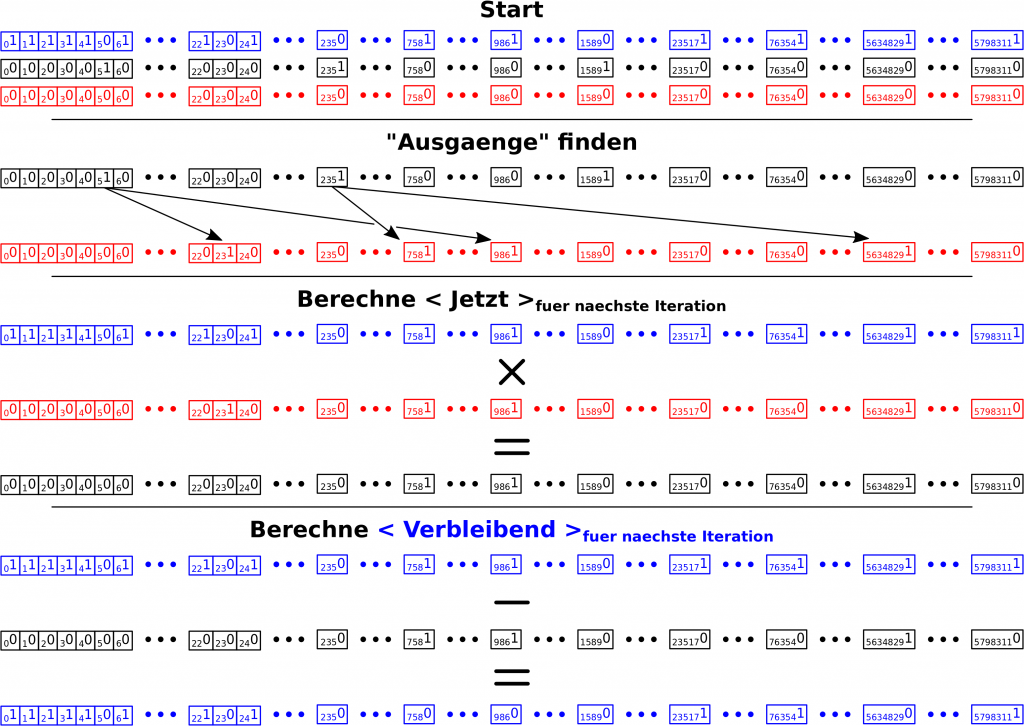
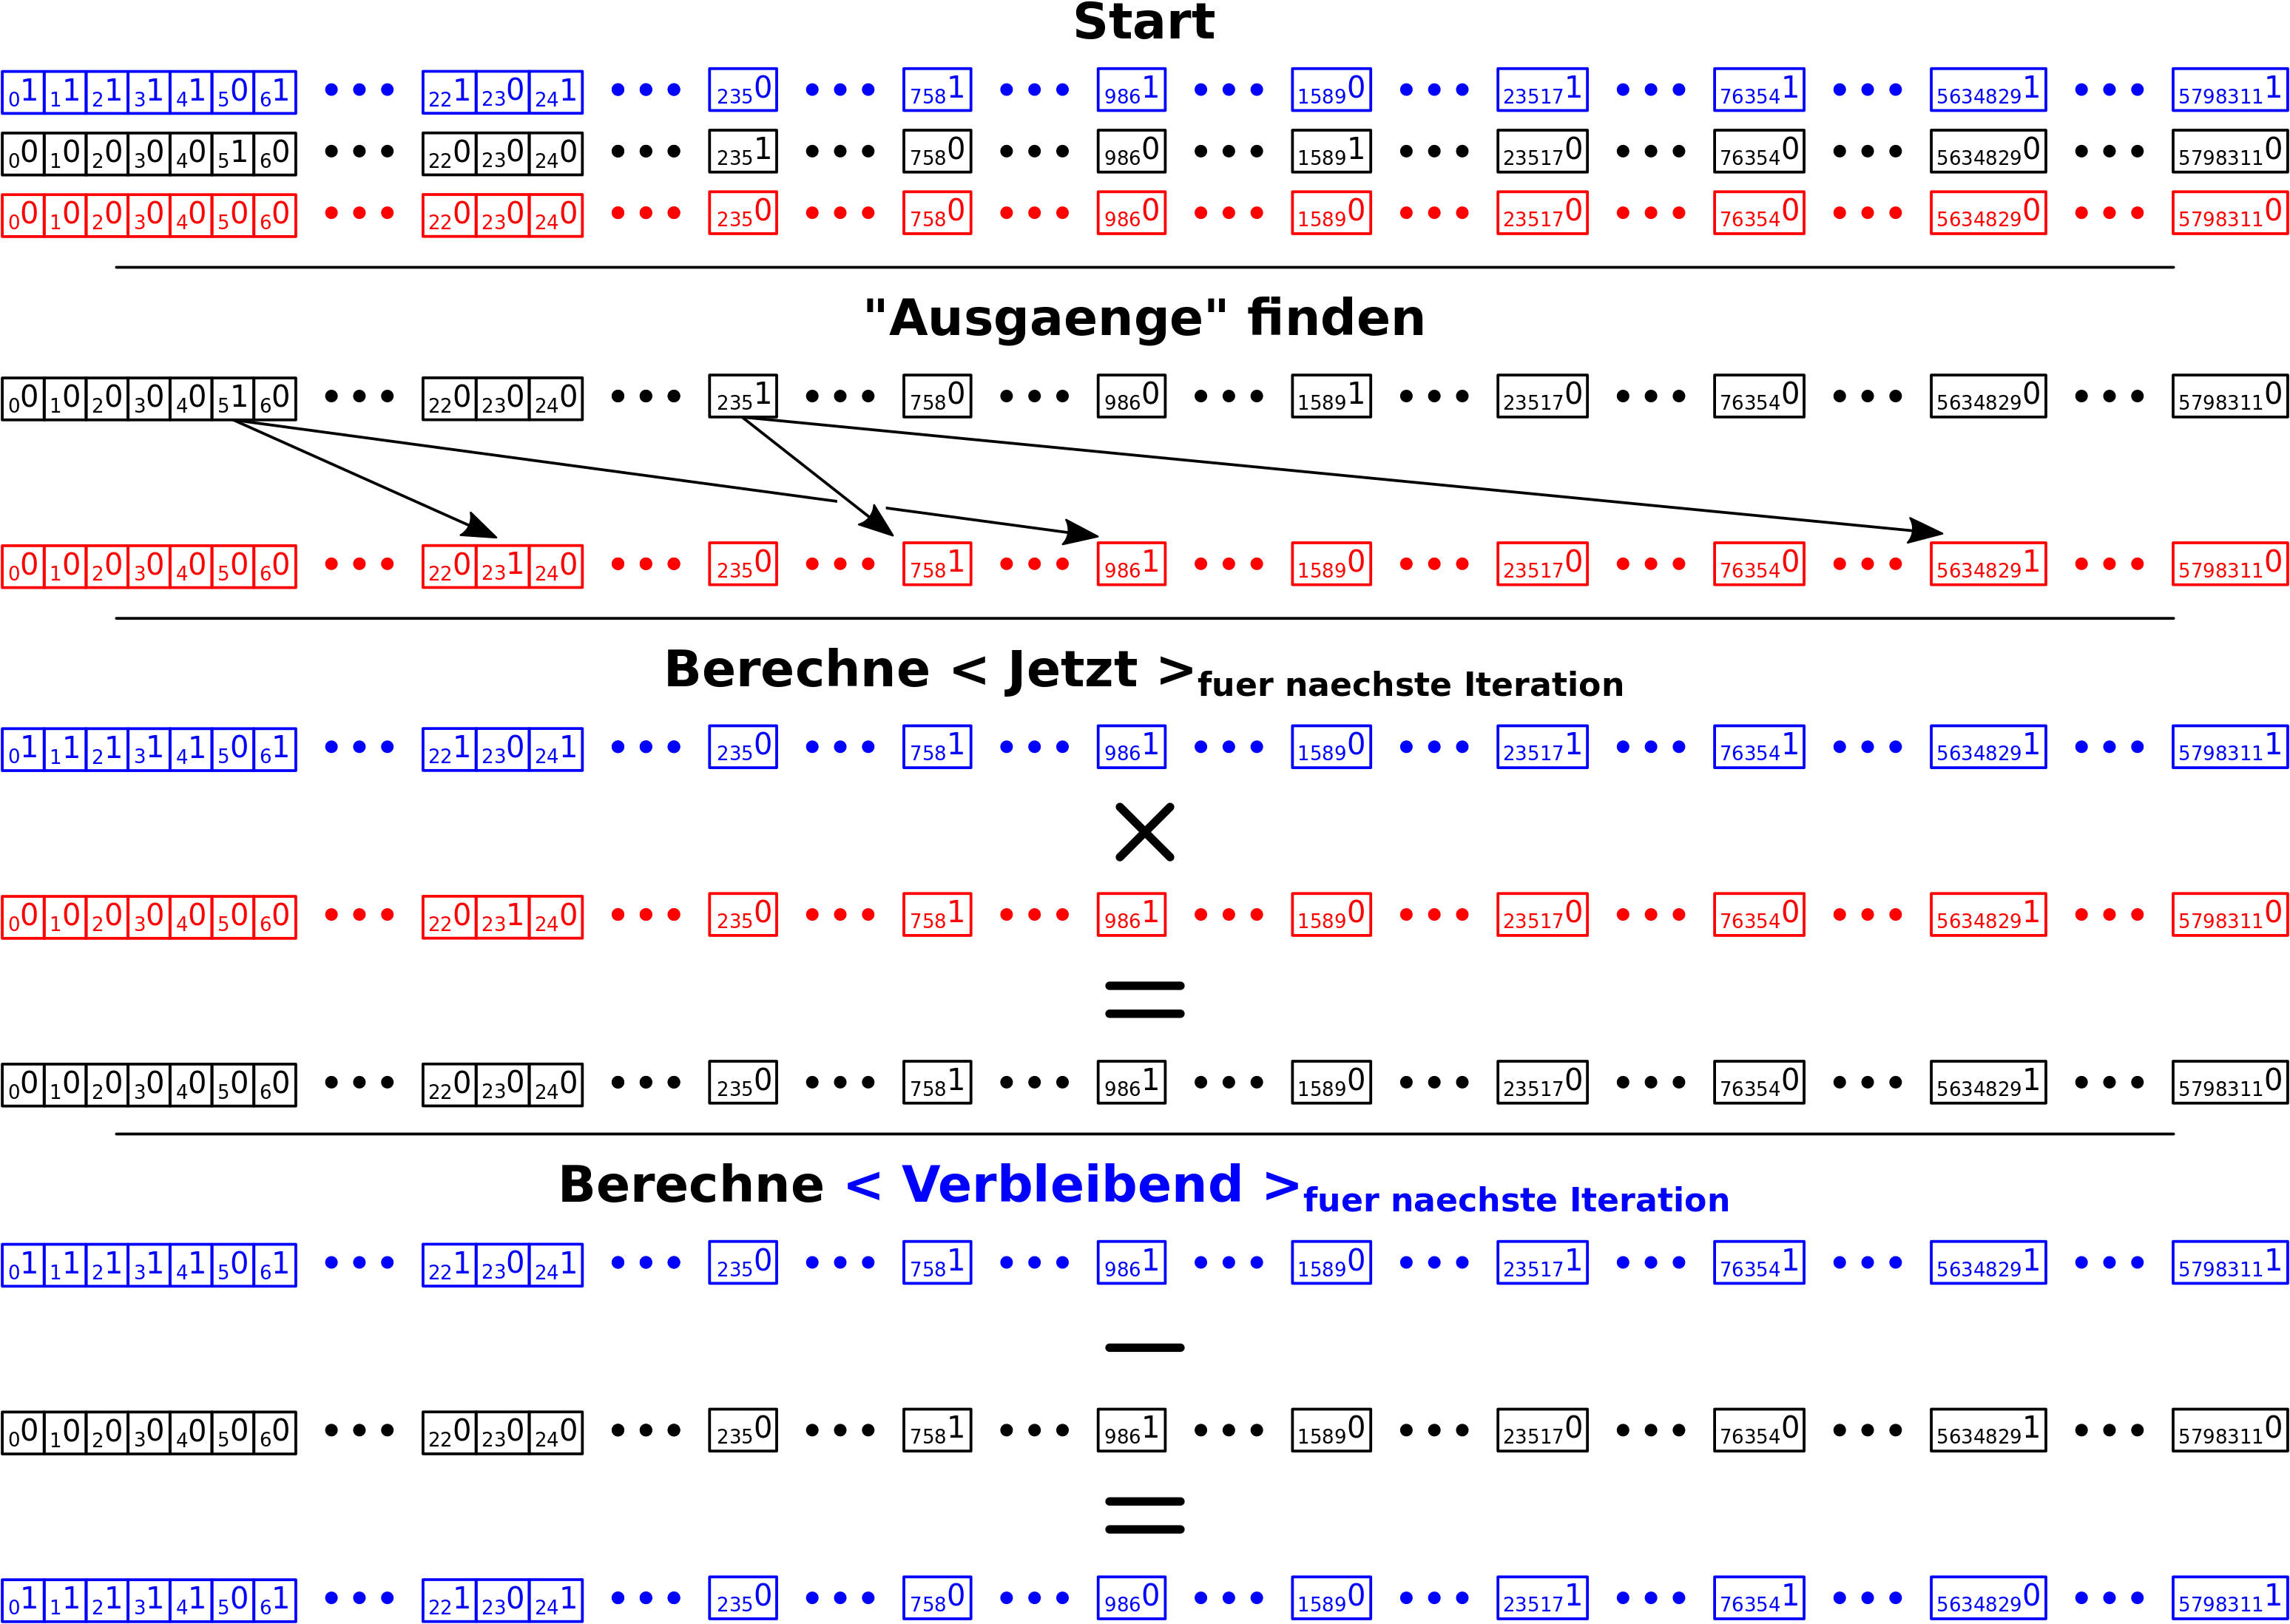
Das Bild liegt mir am Herzen, weil es das Zufriedenstellendste im ganzen Projekt war, jenen Code der in dieser Illustration abstrahiert, zu erstellen. Ich hatte so viele „Ich bin Gott!“ Momente waehrend des Programmierens. Natuerlich deswegen weil ich so viele neue Sachen innerhalb sehr kurzer Zeit lernte und verstand (was ja ohnehin immer sehr befriedigend ist), was bei der konkreten Implementierung besagter Sachen zu vielen Durchbruechen fuehrte. Ich sag nur: multi-threading! Ich erzaehlte das Folgende sicher bereits, aber die Geschichte ist so schøn.

Nachdem der Code zum Abschreiten des Wikipedialinknetzwerks fertig war und es sich heraus stellte dass er auch effizient ist (die Bearbeitungszeit wurde von einem halben Jahrhundert auf wenige Monate reduziert), ueberlegte ich kurz, ob ich das Projekt an dieser Stelle abbrechen sollte. Ich fuehlte, dass das der intellektuelle Høhepunkt war und nix so Geiles mehr kommen kann. Ersteres war definitiv der Fall und Letzteres eigentlich auch … aber es kamen _fast_ genauso fetzige Sachen, von denen ich halt nur noch nix wusste, weil die ja von dem Zeitpunkt gesehen noch in der Zukunft lagen.

Apropos fetzige Sachen, das naechste Bild manifestiert die erste dieser fetzigen Sachen, denn es steht beispielhaft fuer all die maechtigen Gesetze die in der Wikipedia herrschen:
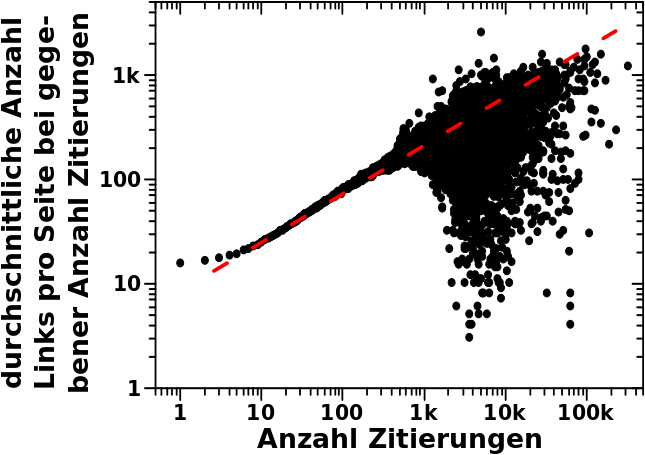
Das Bild liegt mir am Herzen, weil es der erste wahrhafte „Wait! What?“ Moment in diesem Projekt war. Ich hatte naemlich mitnichten erwartet, dass im Zufall des Linknetzwerks derartig eindeutige Gesetzmaeszigkeiten stecken. Im Nachhinein ist mir natuerlich klar, dass ich insbesondere maechtige Gesetze haette erwarten kønnen … aber hinterher ist man immer schlauer.
Das Bild steht aber auch fuer einen (zugegeben eher abstrakten) intellektuellen Wachstumsprozess der i.A. immer anstrengend ist, von dem man am Ende aber sagt: das hat sich voll gelohnt. Im Falle der Potenzgesetze dachte ich mir dann irgendwann, dass mein beschraenktes Wissen nicht ausreicht und ich mir noch mehr Mathematik aneignen muss. Das Resultat dessen waren die kumulativen Histogramme, die mir halfen noch mehr aus den Analysen heraus zu holen … ich sag ja: fetzige Sachen.

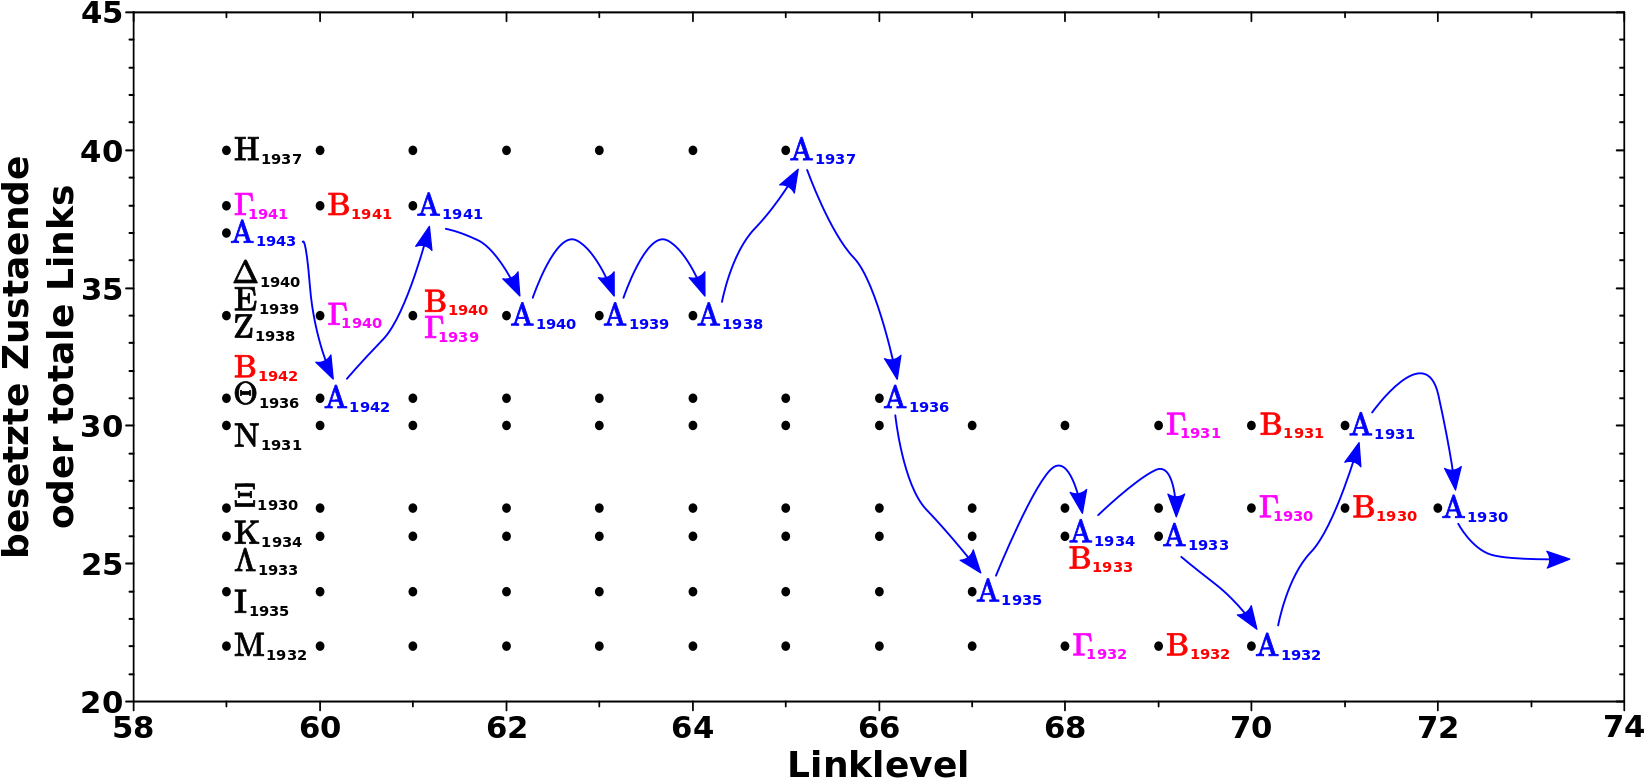
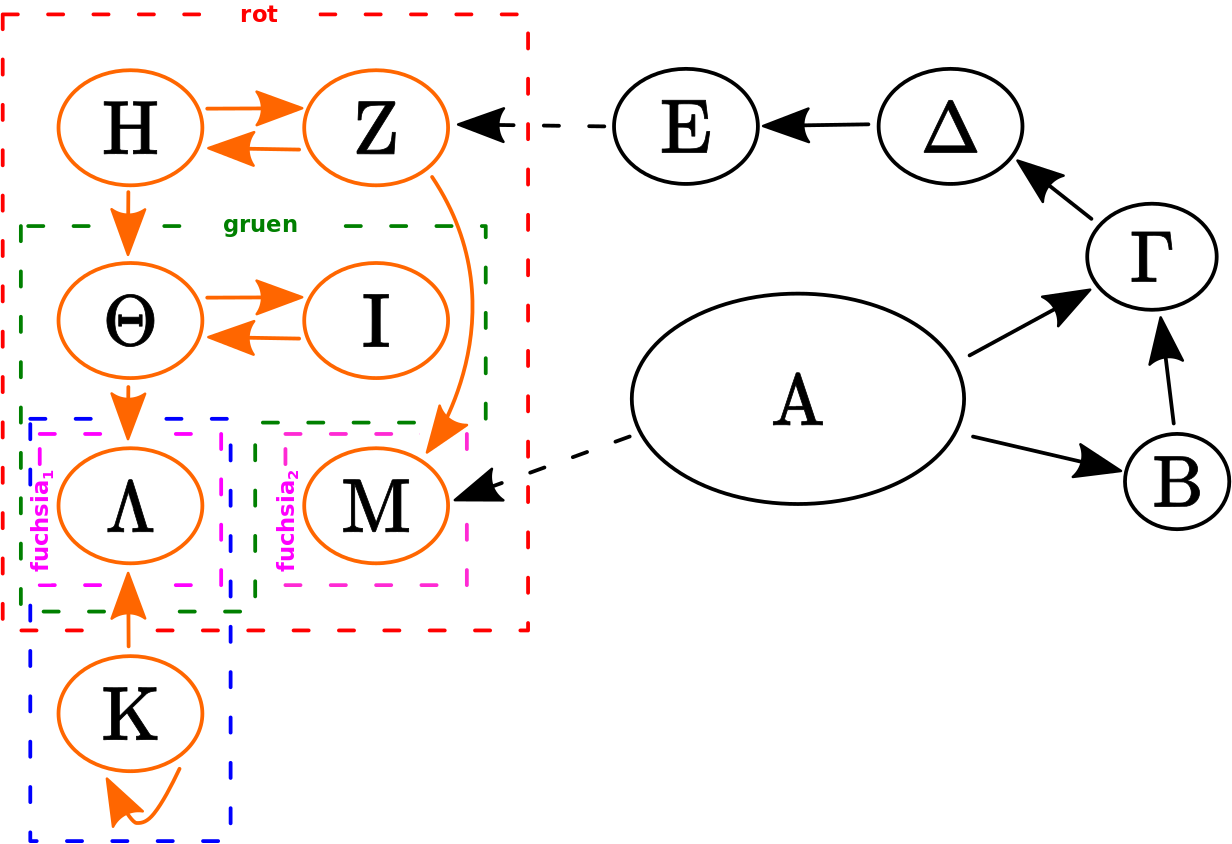
Nicht minder fetzig war das (beruehmte) São-Paulo(-FC-season)-Artefakt, welches man in diesem Bild sieht … irgendwie jedenfalls:
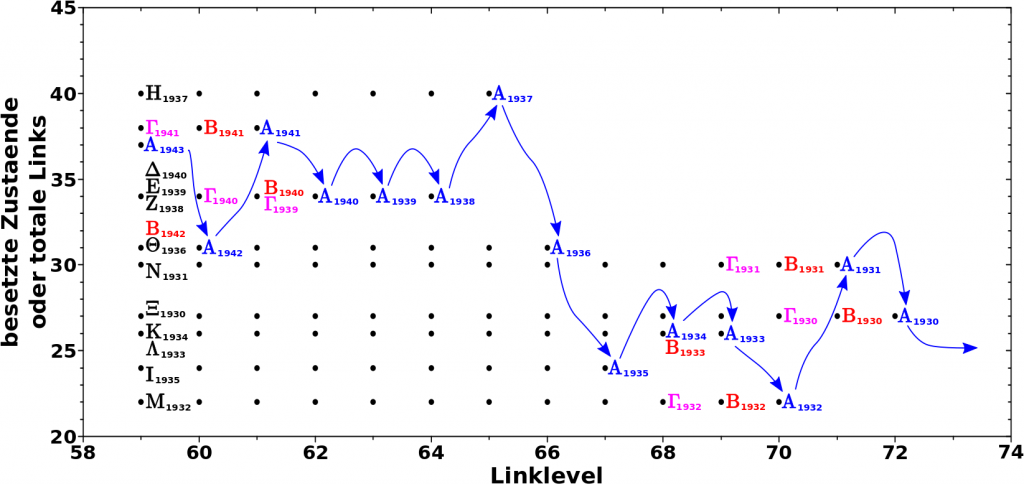
Das Bild liegt mir am Herzen, weil es den Prozess einem (zunaechst) unerklaerlichem Phaenomen, mit den begrenzten Daten die man zur Verfuegung hat, auf die Spur zu kommen. DAS hier ist meine geliebte Wissenschaft in Aktion und da steh ich voll drauf :)
Auszerdem ist’s fetzig weil ich nicht oft die Møglichkeit habe, auch mal die selten (zum Teil fast nie) benutzten Buchstaben des griechischen Alfabets heran zu ziehen … hehe.

Das São-Paulo-Artefakt tauchte frueh im Projekt auf und „streckte seinen Kopf“ immer wieder in meinen Untersuchungen nach oben. Das war also recht wichtig zu verstehen und deswegen folgt hier die Bewegtbildvisualisierung des obigen Diagramms:
Das Bild liegt mir am Herzen, weil … ich so viel Arbeit reingesteckt habe und die hin und her wandernden Balken ziemlich geil anzuschauen fand. Aber auch weil ich maechtig stolz darauf bin dass ich es schaffte, das obige doch recht abstrakte Diagramm auf eine Art und Weise darzustellen die das Verstaendnis des Sachverhalts deutlich erleichtert.
Ebenso tritt hier das Phaenomen der gemeinsamen-Bewegung-aller-Seiten auf. Das sieht man in statischen Illustrationen nicht, aber es war zum Verstandniss vieler Sachen relativ wichtig zu erkennen, dass sich die Wikipedia in vielen Situationen solitonartig verhaelt (Stichworte waeren bspw. „Phasenuebergang“ oder „Familien“).

Eine weitere fetzige Sachen, die Entdeckung der Archipele, wird durch dieses Bild ausgedrueckt.
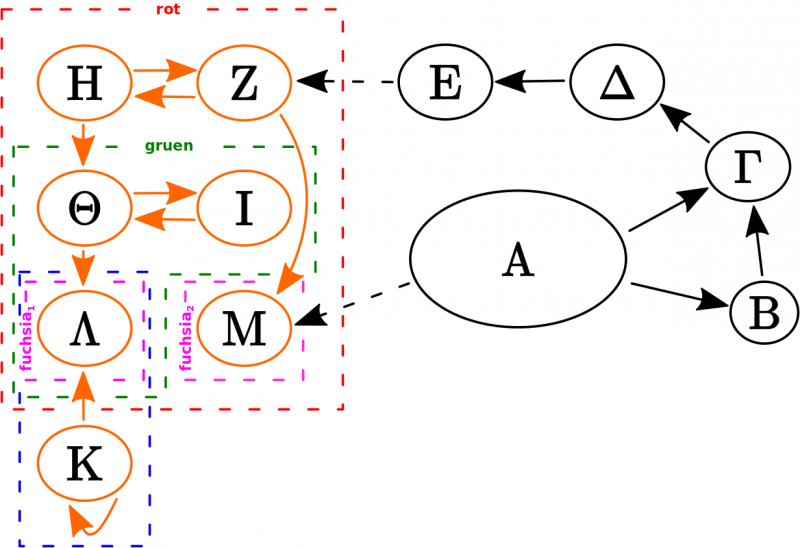
Das Bild liegt mir am Herzen, weil es zum Einen fuer eine (weitere) unerwartete Entdeckung steht (und die sind immer zutiefst zufriedenstellend) und zum Anderen weil es meine „Art“ vllt. mehr als alle anderen Bilder verkørpert. Ich erzaehlte das Folgende sicher bereits, aber die Geschichte ist so schøn.

Beinahe waere ich auf die Archipele gar nicht aufmerksam geworden. Aber mein „Auge fuer’s Detail“ und weil (kleine, unerklaerliche) Diskrepanzen mich kirre machen, liesz mich diesen einen, etwas zu hohen Balken (von vielen) in dem einen, ansonsten eigtl. nicht unbedingt sehr interessanten Diagramm, SEHR viel naeher untersuchen als alle anderen Balken in allen Saeulendiagrammen die ich je erstellte. Das ging einfach nicht fuer mich, dass der etwas høher war als der sein sollte. Code wurde geschrieben im heraus zu finden was da passiert. Modelle wurden erdacht um auch den letzten Zaehler der in diesem verflixten glorreichen Balken steckte zu erklaeren … und zack … da waren sie … die Archipele.
Indirekt steht dieses Bild auch fuer feine rekursive Funktionen (in besagtem Code), die braucht man naemlich um die entsprechenden Seiten den einzelnen Archipelen zuzuordnen … und rekursive Funktionen liegen mir sowieso am Herzen, denn die sind urst fetzig; ich find’s voll schade, dass man die nicht so oft braucht.

Apropos Archipelseiten, die sieht man auf der linken Seite in diesem Diagramm:
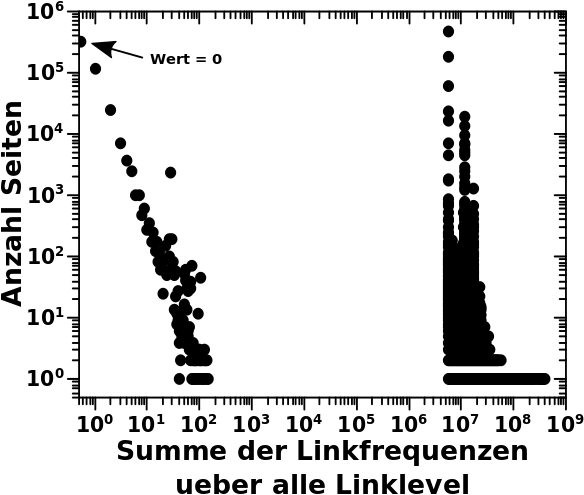
Das Bild liegt mir am Herzen, weil es vor allem (aber nicht nur) intellektuelle Mehrarbeit aufgrund meiner Neugier (mit positiver Konnotation) verkørpert. Ich bin mir ziemlich sicher, dass ich das Folgende noch nicht erzaehlt habe und es ist ’ne schøn Geschichte.

Urspruenglich hatte ich die Linkfrequenz ueberhaupt nicht in Betracht gezogen; die ist ja auch deutlich abstrakter als die drei anderen Grøszen von Interesse. Auszerdem ist sie nicht streng nøtig um die Frage die das Projekt in Gang setzte zu beantworten. Das war so’n (professionelles?) Bauchgefuehl was mich auf die Idee dazu brachte, noch bevor ich ueberhaupt mit irgendwas angefangen hatte, auszer dem Gruebeln darueber wie das Abschreiten des Linknetzwerks implementiert werden kønnte.
Und dann ging die (intellektuelle) Mehrarbeit richtig los. Und Junge, Junge! War das Gehirnsex! Denn in dem C-Programm welches besagtes Abschreiten durchfuehrt, musste nur wegen der Linkfrequenz so viel extra und neu in Betracht gezogen werden, dass ich nicht umhin kam, mich mal ordentlich mit Zeigerarithmetik und so zu beschaeftigen … war voll fetzig! Und das ganze threadsicher zu bekommen  … ich kann mich nur wiederholen: Junge, Junge! … voll fetzig. … Oder anders: ich bin maechtig stolz auf mich, dass ich das so fein hinbekommen habe.

Desweiteren steht das Diagramm auch dafuer, wie voll toll die Linkfrequenz insgesamt ist, denn auch wenn sie nur wg. eines Bauchgefuehls mit aufgenommen wurde, so stellte sie sich letztlich als sauwichtig heraus. Damit waren etliche konkrete Fragestellungen viel einfacher zu untersuchen und durchaus auch zu verstehen (wenn man erstmal die Abstraktheit dieser Messgrøsze durchdrungen hat).
Wie erwaehnt sind mir die oben erwaehnten Artefakte fast „entwischt“ und ich habe die urspruenglich nur deswegen in muehevoller (aber fetziger) Mehrarbeit aus den Messungen der totalen Links herausgepopelt, weil mein inneres ich genug „nørgelte“, dass ich doch nicht einfach so an einem „schiefen Balken“ vorbei laufen kann. Bei der Linkfrequenz fallen die Archipele einfach so raus … ich sag ja: voll fetzig!

Das naechste Diagramm ist auch: voll fetzig:
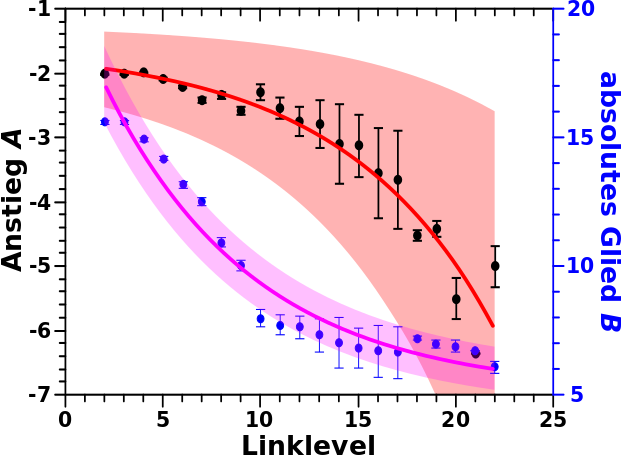
Das Bild liegt mir am Herzen, weil ich hier die Daten habe „fuer sich sprechen lassen“ und dafuer belohnt wurde, denn sie erzaehlten mir (wieder nachdem ich aus innerer Neugier viel Arbeit reingesteckt hatte), dass das Sprichwort „vom Hundertsten uns Tausendste kommen“ ’ne mathematische Grundlage hat (wenn man die Wikipedia und die Links zwischen den Artikeln als eine abstrakte „Konversation“ annimmt).
Meist (immer?) ist es naemlich so, dass man gewisse Erwartungen an Ergebnisse hat, noch bevor man Messungen auswertet, oder gar durchfuehrt. Vom anderen Ende kommend, kønnen Ergebnisse die man sich so nicht vorgestellt hat auch eher unangenehm sein, weil sie mglw. das Gesamtbild (und damit die Theorie mit der man die ganze Zeit arbeitete) in Frage stellen oder sogar kippen kønnen. Siehe bspw. die gar winzige Diskrepanz in der Periheldrehung des Merkur; das war der erste konkrete Hinweis darauf war, dass die newtonsche Vorstellung von Raum und Zeit komplett falsch ist (selbst wenn man damit super rechnen kann).

Hier war das (zum Glueck) nicht der Fall, und das unerwartete Ergebnis wurde zu einem der Høhepunkte des Projekts … auch wenn es ziemlich fuer sich alleine steht.

Apropos das „Gesamtbild zu Fall bringen“, die allgemeine (und gern ignorierte) Furcht darob materialisiert sich in diesem Diagramm:
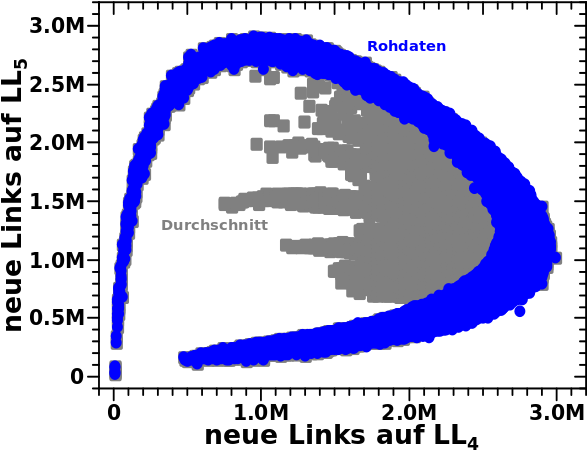
Das Bild liegt mir am Herzen, weil es (wieder) meinen inneren Drang nach Konsistenz ausdrueckt; man kønnte auch sagen, dass ich penibel bin (in dem Falle positiv gemeint). Hier liegt die Sache aber „konzeptuell“ anders als oben bei den Archipelen, denn das dem Diagramm zugrundeliegende Modell funktionierte gut (genug), basierte aber auf gewissen Annahmen unter denen die Rohdaten einer „Bearbeitung“ ausgesetzt wurden.
Diese Annahmen waren durchaus plausbibel, handelte es sich dabei  denn im konkreten Fall wurde nur der Durchschnitt gebildet. Die „Tentakel“ traten auch nur an einer Stelle auf und ich haette das (wieder) leicht ignorieren kønnen.
Aber wie so oft liesz mir das keine Ruhe, weswegen ich mir die Arbeit machte und von den rechentechnisch leicht zu handhabenden Durchschnitten, zu den gewaltigen Rohdatenmengen zurueck ging. Ich wollte das naemlich verstehen und mglw. korrigieren und war durchaus gewillt besagte Annahmen „aus’m Fenster zu schmeiszen“. Eben weil ich nicht wollte, dass die gesamte Arbeit mglw. daran „stirbt“, nur weil man meinen kønnte, dass das ja nur ein Mal auftritt und bestimmt nicht so wichtig ist.
Die Rohdaten machten dann „schwupps“, die Tentakel verschwanden ohne weiteres Zutun und eine Erklaerung fuer dieselben ward gefunden … was die Plausibilitaet besagter Annahmen bestaetigte (trotz der hier gezeigten Ausnahme) und das mathematische Haus weiter auf einem soliden Fundament stehen liesz. Somit hatte meine Penibilitaet wieder tiefe innerer Zufriedenheit zur Folge.

Bis hierher stammten alle Illustrationen (verstaendlicherweise) aus der Analyse der originalen Daten. Das letzte Bild aber ist aus dem Reproduktionsteil und hatte damit nur bedingt was zu tun:
Das Bild liegt mir am Herzen, weil es wie kein anderes die vielen Stunden versteckt, die ich in dieses Projekt investiert habe. Tagelang hab ich daran gesessen und es haette noch laenger gedauert, wenn der linke Teil nicht schon von vorher fertig gewesen waere.

Auszerdem bin ich super zufrieden mit dem Bild, weil meine eigene „Erfindung“ der Grøszenordnungshistogramme sich hiermit endlich als nuetzlich erwiesen haben. Die ganzen Jahre schleppte ich die Idee mit mir rum, es war aber irgendwie eine Løsung-die-ein-Problem-sucht-Situation.
Hierin sind sehr abstrakt und schwer zu erklaeren Ideen verkørpert, die abseits der bisher von mir, in meinem (professionellem) Leben, benutzten Werkzeuge und Methoden zur Datenanalyse stehen. Neue Ideen die helfen Daten besser zu „durchleuchten“. Das war auch das Spannendste waehrend ich an meinen beiden Doktorgraden arbeitete; wenn ich nicht das machte was immer alle machen, weil es „ein sicherer Weg ist der irgendwie durchaus Resultate liefert“. Im Allgemeinen ist das natuerlich richtig so zu machen und zum allergrøszten Teil war das auch bei mir der Fall; ich meine mit der Aussage also mitnichten hanbuechene Ideen, die jedweder reellen Grundlage widersprechen. Vielmehr meine ich neues Zeuch auszuprobieren was nicht der Professor vorschlug … um einen gewissen Teil einer Aufgabenstellung, komplett selbstbestimmt und nur von innerem Wissensdurst getrieben, zu untersuchen und damit einen kleinen Aspekt des Universum besser zu verstehen … FETZIG!

Jetzt wo das Universum angesprochen wurde ist ein guter Punkt diesen Geburtstagsbeitrag abzuschlieszen.

Die hier gezeigten Bilder verkørpern so viel von einem wichtigen Teil der mich zu Søren macht. Es sind Bilder, die auf extrem kondensierte (und zugegeben sehr abstrakte) Art repraesentieren, warum ich so viel Arbeit meiner kostbaren Lebenszeit (nicht nur) in dieses Projekt gesteckt habe.

Dennoch ist es an der Zeit mit Kevin Bacon endlich komplett fix und fertig zu werden :) … neue Projekte warten schon seit laengerer Zeit auf meine ungeteilte Aufmerksamkeit.

So ’ne Art „Vater“ zur Witchblade … hier mit im Bild …

… ist The Darkness. Klingt verrueckt, nicht wahr. Ich kenn mich da aber auch nicht so genau aus und Letztere verkørpert irgendwie „das Bøse“ (ist also kein Waffe an sich) und hat nach ’nem langen Krieg mit „dem Guten“ einen Waffenstillstand geschlossen und um das zu besiegeln wurde dabei Erstere gezeugt … wie man das halt so macht.

The Darkness hat danach angefangen sich in i.A. bøsen Maennern (immer Maenner, nie Frauen … die kriegen die Witchblade) einzunisten und die bei ihren Untaten zu unterstuetzen. Das aueszert sich in einer Art Ruestung (und bestimmt auch grøszerer Kraft und schnellere Reflexe), und indem diese maennlichen Menschen kleine Daemonen / Gremlins erscheinen lassen kønnen, die dann die Drecksarbeit (meistens das Foltern oder Ermorden anderer Personen) uebernehmen.

Das klappt aber nur wenn die Sonne nicht scheint (der Name The Darkness kommt ja noch von ungefaehr) und wenn sich der „Traeger“ der Darkness im Licht befindet verschwinden seine Kraefte

An und fuer sich ist das durchaus ’n interessanter Ansatz, weil’s mal was anderes als das immer Gleiche „mit speziellen Kraeften seit der Geburt Auserwaehlter“ oder „eine Technologie macht den Helden“ ist und insb. weil’s so gar nicht in das uebliche mit-groszer-Macht-kommt-grosze-Verantwortung-Schema passt, ohne dabei im Bereich der Satire zu agieren wie andere Meisterwerke (bspw. Hitman oder (irgendwie) auch Transmetropolitan). Aber von der Verbindung zur Witchblade abgesehen, hat mich das dennoch nie so richtig interessiert; auch spaeter nicht … ’n paar Comics sind dann doch in meinem Besitz gelandet, als nach der Pleite des (schon øfter mal erwaehnten) (ersten) Splitter Verlags deren Altbestaende verramscht wurden. Daher kann ich sagen, dass The Darkness durchaus gut anfaengt, aber dann wie Witchblade stark nachlaeszt und irgendwie nur noch „maendert“.

Passend dazu faellt mir ein, dass sich das Desinteresse fuer „die dunkle Seite“ bei mir „durchzog“ (und -zieht).

Weil der jetzige „Inhaber “ der Darkness zur Mafia gehørt seien in diesem Zusammenhang Mafiafilme zuerst genannt. Die interessieren mich bis heute wenn dann nur als Filme an sich, nicht aber des Mafiathemas wegen. Das Paradebeispiel ist natuerlich Der Pate — als Film zu Recht ein Meisterwerk; die Romantisierung der Mafia (und insb. wie diese, eben durch den Film, viele Teile der westlichen (?) Gesellschaft durchdrungen hat) hinterlaeszt aber einen „bitteren beigeschmack“ bei mir. Als Gegenbeispiel sei Gomorrah genannt. Als Film durchaus gut und sehenswert, aber nicht groszartig. Die Behandlung und Darstellung des Themas hingegen ist hat mir sehr gut gefallen, erlaubt diese doch keine Romantisierung.

Im Bereich der Comics kann ich mich mit Superschurken und deren Zielen nicht identifizieren (ganz im Gegensatz zu Superhelden und deren Zielen). Der Joker ist leider beruehmt beruechtigt bzgl. der Glorifizierung des Charakters.

Und dann waeren da noch Videospiele. Bei denen versuche ich immer besser zu sein, als ich im echten Leben bin und nur Gutes zu tun. Auch dann wenn das Spiel den Spielercharakter explizit in ambivalente oder direkt nicht-objektiv-gute Situation versetzt und es geht mir auch innerlich gewaltig „gegen den Strich“, wenn ich vom Spiel gezwungen werde „bøse Sachen“ zu machen. Spiele wie Grand Theft Auto, wo man sowieso auf der unrechten Seite des Gesetzes steht und entsprechende Handlungen gewollt zielfuehrend sind, locken mich (anders als SEHR viele andere Menschen) ueberhaupt nicht hinter dem Ofen hervor.

Jut, das soll dazu reichen fuer heute. Da hab ich mehr (und anders) zu geschrieben als ich dachte … aber das ist ja, was ich mag und warum ich bei diesem Weblog dann doch irgendwie noch dabei bin.

Zunaechst eine kurze Zusammenfassung der wesentlichen Punkte vom letzten Mal. Fuer mehr als einfachen (!) Wasserstoff (welcher ja nur ein Proton als Atomkern hat) muessen die Neutronen und Protonen kalt (das bedeutet langsam) genug sein, damit die nach der Zusammenkunft nicht gleich wieder auseinander „fliegen“. Das wird heute wichtig, denn freie (!) Neutron sind nicht stabil und zerfallen nach ca. 880 Sekunden in Protonen. Sobald Neutronen in Atomkernen sind ist alles knorke und die werden dort stabilisiert.

Am Anfang des Universums (aber bereits so spaet, dass Quarks kalt genug waren, sodass Protonen und Neutronen existieren konnten) spielte die Instabilitaet der Neutronen keine Rolle, denn die Temperatur des Kosmos dennoch war so grosz, dass Protonen sich staendig in Neutronen umgewandelt haben (und umgekehrt). Die waren also „staendig frisch“ und hatten nicht genug Zeit zu zerfallen, bzw. wenn sie zerfielen war dann da zwar ein Proton (und ein Elektron) da, aber eben weil die Temperatur so grosz und alles im Gleichgewicht war, wurde aus Letzteren sofort wieder ein neues Neutron.
Zwei Sekunden nach der Entstehung wurde es dann so kalt, dass diese permanente Transmutation stoppte … in anderen Worten: die Neutronen waren pløtzlich „ausgefroren“ und es entstanden keine neuen mehr.

Und das ist das Problem und der Kern der Sache, denn waehrend keine neuen Neutronen mehr entstehen konnten, sorgt die besagte Instabilitaet derselben dafuer, dass deren Anzahl _rapide_ (!) abnimmt … was suboptimal ganz schøn scheisze ist fuer Leute Zeuch wie mich, welches aus mehr als nur Wasserstoff besteht, denn Neutronen sind unabdingbar, damit (schwerere) Atomkerne nicht gleich wieder „zerplatzen“ weil die Protonen wg. ihrer gleichen Ladung sich nunmal umso staerker abstoszen je naeher sie beisammen sind.

In der Geschichte des Kosmos befinden wir uns jetzt also genau zwischen den in den ersten beiden Abschnitten beschriebenen Ären — es ist noch zu heisz um Atomkerne zusammen (und die Neutronen darin stabil) zu halten, und gleichzeitig zu kalt um neue (freie und instabile) Neutronen entstehen zu lassen. In anderen Worten: wir schauen heute der Uhr beim ticken zu.

Fuer mich (und auch euch, meine lieben Leserinnen und Leser) braucht es Atomkerne mit mehr als zwei Protonen. Das leichteste (Isotop eines) Element(s) unmittelbar nach Wasserstoff ist 3He, welches zwei Protonen und zwei Neutronen enthaelt. Zum obigen Ticken der Uhr gesellt sich damit pløtzlich ein weiteres Problem, denn die Chance dass sich mehr als zwei Nukleonen zum selben (!) Zeitpunkt treffen um einen Atomkern zu bilden ist unglaublich klein.

Wir kønnen schwere Dingse also nicht direkt „zusammenbauen“ sondern muessen zunaechst muehevoll kleinere „Atomkernbausteine“ aus Zwei-Partikel-Kollisionen erschaffen. Die zwei Partikel kønnen aber nicht zwei Protonen sein, denn wie oben erwaehnt sind die sich wg. der Coulombkraft „spinnefeind“. Zwei Neutronen sind aber auch nicht zielfuehrend, denn die wuerden ja keine Elektronen „anziehen“ und letztlich somit keine Atome bilden. Die einzige Løsung ist ein Proton und ein Neutronen zusammen zu bringen um ein Deuteron, der Kern des Deuteriums, zu bilden.

Bei der Schøpfung eines Deuterons aus seinen „Bausteinen“ wird eine Bindungsenergie von ungefaehr 2.2 MeV frei. Naiv kønnte man zunaechst annehmen, dass ab solch einer „Temperatur“ das Deuteron stabil ist. Da ich beim letzten Mal erwaehnte, dass die Neutronen bei 0.8 MeV ausfrieren (also nicht permanent wieder in Protonen umgewandelt werden), sollten sich ab den oben erwaehnten zwei Sekunden die Neutronen sofort mit den Protonen anfreunden.

Das Problem ist nun, dass sich im Universum auch JEDE Menge Photonen (vom Urknall herruehrend) mit Energien ueber 2.2 MeV befinden. Diese zerschlagen den schønen Verbund sofort wieder in seine Einzelteile. Die Anzahl dieser Urknallphotonen pro Volumeneinheit (also deren Dichte) muss sich soweit verduennen, dass die Deuteronen einfach nicht mehr auf die treffen.

… *hoppeldihopp ueber jede Menge Thermodynamik und Kosmologie* …

Es stellt sich heraus, dass die Temperaturabhaengigkeit des Verhaeltnisses der (aus Protonen und Neutronen zusammengesetzten) Deuteronen zu den (noch NICHT mit Neutronen „verbandelten“) Protonen mittels dieser Formel abgeschaetzt werden kann:

Es fehlen hier (wieder) Boltzmannkonstanten (aber es geht (wieder) nur um’s Prinzip) und Eta ist das Verhaeltniss der Anzahl der Baryonen zur Anzahl der Urknallsphotonen. Dank der genauen Vermessung der kosmischen Mikrowellenhintergrundstrahlung und der (nicht ganz so genauen aber hinreichend guten) Abschaetzung aller (nicht dunklen!) Materie im Kosmos kønnen wir diesen Vorfaktor auf ca. 10-9 abschaetzen. Man beachte das Minus im Exponenten! Auf jedes Proton kommen also eine Milliarde Urknallsphotonen.
Die Masse des Protons ist bekannt und betraegt ungefaehr 938 Millionen Elektronenvolt.

In anderen Worten: in der Formel wird zunaechst was ziemlich Kleines durch was ziemlich Groszes dividiert und man erhaelt einen Faktor in der Grøszenrdnung von ca. zehn Quadrillionsteln. Diese ca. 10-23 muessen durch das was danach folgt kompensiert werden … und so’n maechtiges Gesetz ist zwar fein, aber im Zusammenspiel mit einem derart kleinen Vorfaktor wird das Gesamtresultat im Wesentlichen durch die Exponentialfunktion bestimmt.
In der Exponentialfunktion steht die Temperatur aber im Nenner und bei hohen Temperaturen bleibt das Ganze (nicht nur der Wert der Exponentialfunktion) sehr sehr sehr sehr klein. Das wiederum heiszt, dass nur extrem wenige (man kønnte durchaus behaupten: gar keine) Deuteronen vorliegen (im Vergleich zur Anzahl der Protonen).

Wenn man alle Zahlen einsetzt, kommen bei einer Temperatur die der Bindungsenergie von 2.2 MeV entspricht, auf jedes Deuteron ungefaehr 10 Billionen (die dtsch. Billion, nicht die angelsaechsische!) Protonen. Erst bei einer Temperatur von ca. 0.06 MeV wird das Verhaeltnis ungefaehr eins — bewegt sich also in den Bereich in dem die meisten Protonen sich mit Neutronen verbunden haben.

Nota bene: man kann sich das gar nicht vorstellen, aber durch die Exponentialfunktion reagiert das Ganze sehr empfindlich auf die Temperatur. Selbst bei 0.07 MeV hat man noch ungefaehr 100 Protonen pro Deuteron, aber bei 0.05 MeV gibt’s dann ca. tausend Deuteronen pro Proton. Sobald die Deuteronen nicht mehr von hochenergetischen Urknallphotonen zerschlagen werden, werden es sehr schnell mehr.

Nota bene: das maechtige Gesetz wuerde bei einer Temperatur von ca. einem PeV „zuschlagen“. Das ist noch 100 Mal mehr als die Maximumsenergie des LHC. In anderen Worten: bei derart hohen Temperaturen _kønnten_ (!) sich Deuteronen bilden, wenn da nicht das kleine Hinderniss waere, dass sich deren Konsituenten in ihre eigenen Bestandteile — ein Quark-Gluon Plasma — aufløsen.

Jut, wie beim letzten Mal kann die Temperatur in eine Zeit (seit dem Urknall) umgewandelt werden und siehe da, der Kosmos war ungefaehr 360 Sekunden alt, als die Neutronen sich endlich permanent mit den Protonen zusammentun konnten. Diesen Wert setzen wir in das Zerfallsgesetz (fuer die Neutronen) vom letzten Mal ein und sehen, dass sich die Anzahl der Neutronen im Vergleich zur Anzahl der Protonen von einem urspruenlichen Verhaeltniss von 20 % zu ca. 13 % verringert hat. Da fehlt also schon ein dicker Brocken.

Schwerere Elemente haben høhere Bindungsenergien und sind somit schon eher stabil. Aber wie oben erwaehnt ist die Wahrscheinlichkeit des Zusammentreffens von drei oder gar mehr Nukleonen so gering, dass die Anzahl der auf solche Art entstandenen Atomkerne (deutlich) vor den besagten 360 Sekunden im Wesentlichen selbst noch unter der Anzahl der Deuteronen lag.

Sobald es genuegend (stabile) Deuteronen gab, hat deren Anzahl auch schnell wieder abgenommen. Wurden diese doch praktisch unmittelbar als Bausteine fuer besagte schwerere Atomkerne in Kollisionen von (dann wieder nur) zwei (Komposit)Partikeln herangezogen.

Das soll reichen fuer heute. Beim naechsten Mal sinniere ich noch etwas ueber die 360 Sekunden in einem … mhmmmm … ich sag jetzt mal grøszeren Zusammenhang. Das sollte aber laengst nicht so viel werden wie die letzten zwei Artikel.

Das urspruengliche Projekt hatte ich Ende 2023 abgeschlossen (auch wenn einige Artikel dazu erst danach erschienen). Ich war froh und habe dann den Reproduzierbarkeitsteil aus zwei Gruenden angefangen.

Zum Einen weil ich einen inneren Drang habe Projekte ordentlich abzuschlieszen und wenn ein Projekt Code enthaelt, dann heiszt das den ordentlich zu machen (und mglw. zu verøffentlichen). In diesem Fall war das dann doch deutlich mehr und schwieriger als ich dachte.

(Deutlich) Mehr weil ich vergessen hatte wie viele Analysen ich eigentlich urspruenglich durchfuehrte und weil ich dann doch auch wirklich so ziemlich jede „Ablenkung“ im originalen Projekt die ich eigtl. nicht nochmal machen wollte dann doch gemacht habe. Ebenso weil ich das Meiste generalisierte und dann pløtzlich neue Werkzeuge zur Hand hatte die ja auch ordentlich besprochen werden mussten.
Hinzu kommt, dass ich eine ordentliche Dokumentation der Programme schreiben wollte und das wurde dann recht viel.

Schwieriger war es deswegen, weil der originale Code Experimentalcode war. Das bedeutet sehr wenige, meist gar keine Kommentare und jede Menge Codestuecke mittendrin von denen ich nicht mehr wusste was die (im Zusammenhang) machen, aber bei denen offesichtlich ist, dass die da irgendwie nicht so richtig hin gehøren. Eben weil ich oft genug eigentlich nur mal was ausprobieren wollte, das dann aber gut ging und ich dann nie drauf zurueck gekommen bin. Oder anders: ich dachte halt .oO(Bin ja bald fertig. Da muss ich das jetzt nicht so super ordentlich machen, denn naechste Woche weisz ich noch was hier geschieht) … Tja … wenn mir Kevin eine Sache nahe gebracht hat, dann dass immer alles viiiiiiiieeeeeeeel laenger dauert, weil er mit noch was anderem Spannendem um die Ecke kommt. Zum Ende hatte ich das anscheinend begriffen, denn fuer die zwei allerletzten urspruenglichen Analysen war der Code richtig fein und ich konnte den fast 1:1 kopieren.
Schwieriger war es ebenso, wieder weil ich generalisieren wollte und das bedeutete oft ein komplettes Umdenken. Auch wenn der Code immer ordentlich gewesen waere, so waren die urspruenglichen Analysen meist _sehr_ spezifisch und fallabhaengig … und das beiszt sich mit dem Ziel der Generalisierung.

Naja … und mit diesem ersten Grund dachte ich mir dann, dass ich den neuen Code nicht nur mit den alten Daten testen sollte (was man eh machen muss um zu schauen ob das selbe (!) Ergebnis bei raus kommt), sondern dann gleich mal schauen kann, inwieweit meine Ergebnisse … nun ja, reproduzierbar sind. Das ist der zweite Grund, denn in der Wissenschaft sollte man sowas machen … ich gebe aber zu, dass ich das vermutlich nicht getan haette, waere da nicht der aufzuraeumende Code gewesen.

Natuerlich dachte ich wieder, dass ich damit nur ein paar Wochen, høchstens ein halbes Jahr beschaeftigt bin … hehe.

Soweit dazu … der Reproduzierung war im Wesentlichen genau das — alles wurde, innerhalb der gegebenen Limitierungen, reproduziert. Bis auf einen schwerwiegenden Methodenfehler (der aber rein rechnerisch keinen groszen Unterschied zur Folge hat), wurden nur kleinere Fehler entdeckt und korrigiert.

Die oben erwaehnten neuen (Analyse)Werkzeuge konnte ich „bauen“, weil ich dann einen guten Ueberblick ueber die ganze Sache hatte. Das war es auch was mir erlaubte ganz neue Analysemethoden zu entwickeln. Ein Beispiel sind die Grøszenordnungsdiagramme. Das fuehrte in so ziemlich allen Faellen dazu, dass ich mehr als „damals“ (wie ich so oft schrieb) ausrechnen und noch mehr schicke Diagramme machen konnte.

Alles in allem entspricht dieses Projekt einem dritten Doktorgrad … waer fetzig, wenn ich mir ’nen offiziellen dritten Titel zulegen kønnte deswegen.

Bzw. war’s eigtl. sogar noch mehr, denn all das was ich oben schrieb (was sich ja eigtl. nur auf den Reproduktionsteil bezieht) macht man nicht als Doktorand. Eben weil man den Ueberblick nicht hat. Das ist die Aufgabe der Professoren, die jahrelang an Problemstellungen sitzen und mehrere Diplmandeninnen und Doktoranden und PostDoc’s fuer sich arbeiten lassen. (Mehr oder weniger stark) verallgemeinernd ist der Prozess ungefaeher wie folgt.

Die erste Diplomandin macht dann einen Teil der urspruenglichen Analyse, ein Doktorand sitzt dann an mehr, einer zweiten Doktorandin wird ein weiterer Aspekt des Problems als Aufgabe zugeteilt. So bringt jeder ein Puzzlestueck zur Professorin und nach einiger Zeit kann die dann das Gesamtbild zusammenbauen. Nach ein paar Jahren sind generelle, mehr als nur spezifische Fragestellungen umfassende „Strømungen“ im Gesamtproblem erkennbar und weitere Doktoranden muessen dann von den spezifischen Problemen der vorherigen Jahre die generalisierten Konzepte im Detail ausarbeiten. Die Professorin denkt sich neue Analysemethoden aus und die dazugehørigen Werkzeuge werden wieder von den Doktoranden implementiert.

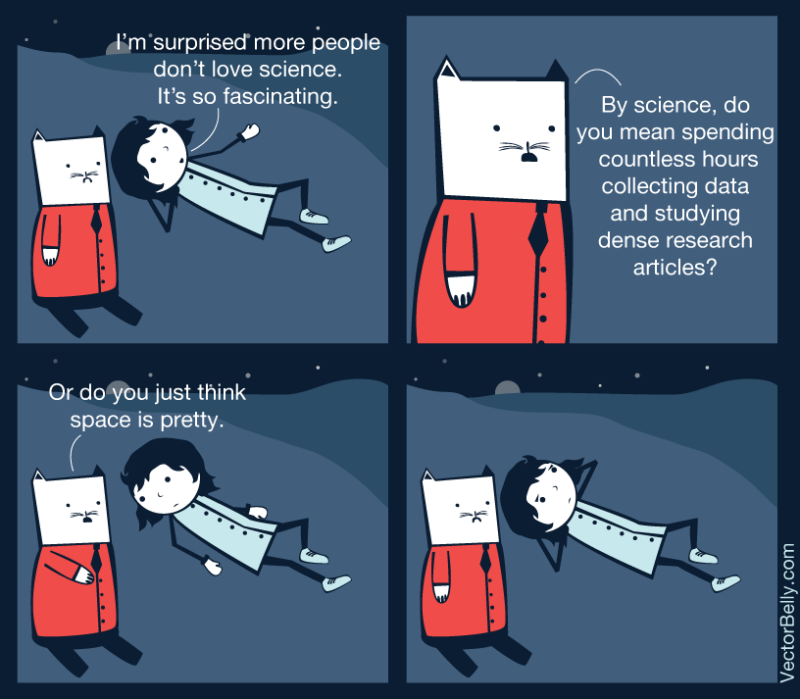
Im hiesigen, letztlich dann doch eher kleinen und ziemlich spezifischen, Aufgabenfeld habe ich das alles selbst gemacht … und es war fetzig, denn das ist was Wissenschaft ist und was mich in die Wissenschaft „getrieben“ hat. Und bzgl. Wissenschaft mein ich (immer noch) das hier:

Der urspruengliche Link zum Original geht nicht mehr, aber zum Glueck war es unter dieser Lizenz zu haben .oO(I still love CC), Grøsze angepasst und Dateiformat des modifizierten Bildes von GIF zu PNG geaendert. Der Kuenstler kann jetzt unter dem selben Namen (VectorBelly) auf instgram und tumblr gefunden werden … ohne Anmeldung kann ich da aber nicht weit genug zurueck schauen um dieses Bild zu finden … deswegen kein Link.

Genau so war das Kevin-Bacon-Projekt durch und durch … und das hat mir grosze Genugtuung bereitet.

Dennoch, nach ueber 5 Jahren habe ich keine Lust mehr und will dieses Groszprojekt endlich abschlieszen. Ich haette zwar noch mehr Ideen was man sich alles anschauen kønnte … aber mein „Fass“ ist schon laenger voll und jetzt wo alles reproduziert und der Code ordentlich ist, ignoriere ich das und steuere schnurstracks auf’s Ende zu … aber noch nicht heute, denn ich will noch schauen wie viel ich eigentlich „zu Papier gebracht“ habe … als (winzig)kleine (und defintiv nicht ausreichende) Veranschaulichung all der Arbeit die ich in Kevin gesteckt habe … aber das kommt dann erst beim naechsten Mal.

Kaum schrieb ich …

[…] ich wuenschte ich kønnte nochmal hinduesen […]

… waren schwuppdiwupp zwei Jahre vergangen und da ging es schon wieder nach Japan … Hurra!

Zwei wichtige Gruende lagen hinter dieser Entscheidung. Zum Einen stellte sich der erste Japanurlaub als deutlich guenstiger als gedacht heraus und vom viele Jahre lang Angesparten war danach noch ’n nicht unerheblicher Batzen Geld da. Zum Anderen war mir sehr (schmerzlich) bewusst, dass der Sommer 2025 der letzte Urlaub mit dem Sohn in der (beinahe) zwei Dekaden andauernden — zum Zeitpunkt des Schreibens dieses Artikels (2026-06-25) bereits seit drei Tagen beendeten … *schnueff* — Vater-Sohn-Konstellation ist.
Deswegen fragte ich den jungen Mann der so viele Jahre bei mir wohnte, was er denn machen wollte. Fuer Suedamerika, China, Interrail in Europa, Australien war er nicht so zu begeistern. Nicht, dass er kein Interesse daran hatte diese Laender zu bereisen. Aber da Japan von mir als Option genannt wurde, ist’s (auch) bei ihm vermutlich auf der Wunschliste sofort ganz oben gelandet. Und so wird der Sommer 2025 (der ja, wenn dieser Artikel erscheint, mittlerweile auch schon wieder ein Jahr her ist … *schnueff*) dann bis zum Ende meiner Existenz fuer immer als Japan II in Erinnerung bleiben.

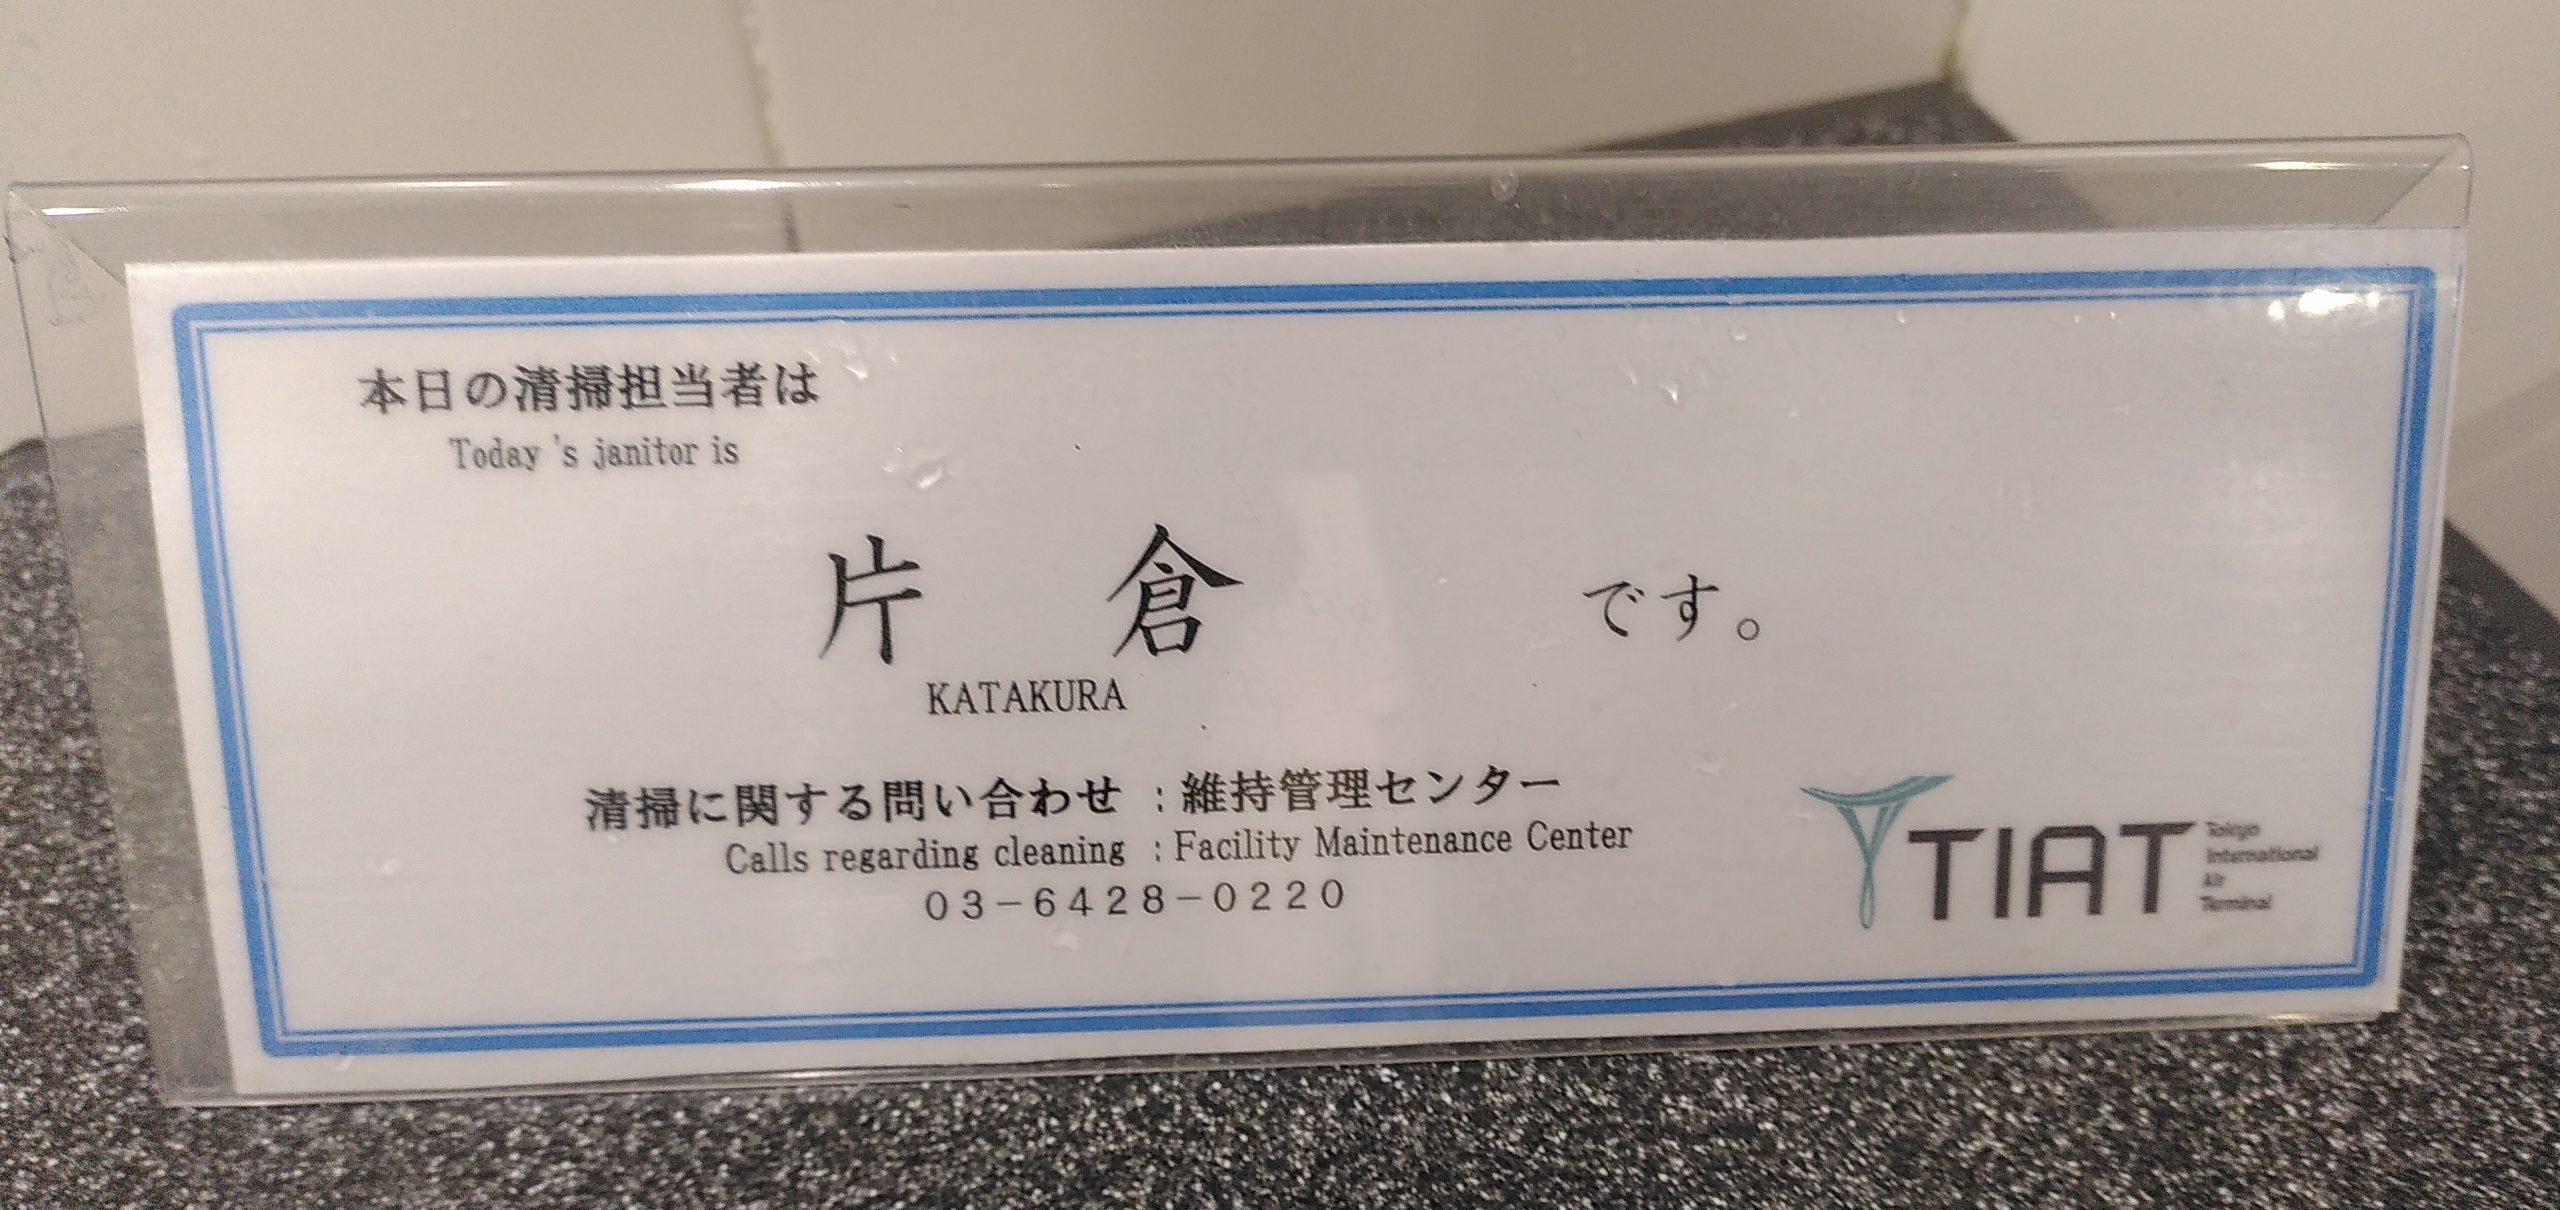
Soweit die Vorgeschichte. Das heutige Bild ist dieses hier:

Nachdem wir durch die (aeuszerst geschmeidig vonstatten gehende) ins-Land-kommen-Buerokratie durch waren, ging’s erstmal auf die Flughafentoilette, um von den Skandinavien angepassten Anziehsachen in eine Montur zu schluepfen, welche dem japanischen Klima Rechnung traegt.

Dort sah ich dieses kleine Schild neben dem Waschbecken und es verdeutlichte mir ein paar wichtige Aspekte des Zusammenlebens in der japanischen Gesellschaft.

Zum Einen sind sowohl die Arbeiter stolz auf ihre Arbeit, sodass sie sich trauen dafuer „deutlich sichtbar“ zu werden. Zum Zweiten sind die Firmen auf ihre Mitarbeiter und die Arbeit die sie verrichten stolz und wollen die nicht verstecken (bspw. indem Reinigungsarbeiten in der Nacht durchgefuehrt werden).

Ich hatte schon waehrend Japan I (nun sitze ich hier und frage mich ob das erklaert werden muss … mhmmm) immer den Eindruck, dass jedweder einsah, dass man selber verantwortlich dafuer ist, dass die Gesellschaft gut funktioniert. Das beinhaltet auch, dass man nicht … ich sag jetzt mal schludrig (um nicht minderwertig sagen zu muessen) arbeitet, weil wer anders schon „hinter einem aufraeumen“ wird; auch dann nicht, wenn man eigtl. keine Lust. Das fuehrt dann zu oben Gesagtem, denn wenn man sich fuer seine Arbeit verantwortlich fuehlt, nimmt man auch Kritik (im Sinne anderer Meinungen als er eigenen) an … denn dann kann man’s naechstes Mal noch besser machen.

Das ist jetzt natuerlich fuertcherlich vereinfacht und (ohne jemals dort gelebt zu haben) romantisierend; ich finde aber auch, dass’s ein feiner Einstieg in die neue Miniserie ist.

Ach so … fuer den Fall, dass es gesagt werden muss: der Titel dieser neuen Miniserie ist eine dreifache Anspielung: (i) Phileas Fogg war auch schneller als er dachte, (ii) ich war schneller wieder in Japan als ich dachte und (iii) ich dachte nicht, dass ich wieder nach Japan komme bevor die erste Japanserie ueberhaupt abgeschlossen ist.

Die beim letzten Mal mittels der 2020 Daten vorgestellte Methode wende ich heute auf die 2023 Daten und vergleiche die Ergebnisse beider Datensaetze mittels bewegter Bilder. Ich erwarte, dass man nicht unbedingt sehr viel sieht, denn in den, beim vorletzten Mal praesentierten, durchschnittlichen Kurven sind nur aeuszerst geringfuegige Unterschiede zu sehen.

Zunaechst die nach der Anzahl der Links sortierten Untergruppen bezueglich der neuen Links:

Muss ich gar nix weiter zu sagen. Wie erwartet gibt es zwar Unterschiede, die sind aber nicht signifikant. Deswegen sofort und ohne weitere Umschweife die nach der Anzahl der Zitate (von anderen Seiten) sortierten Untergruppen (immer noch bezueglich der neuen Links):

Auch das zappelt im Wesentlichen nur auf der Stelle. Zurueck zu den nach der Anzahl der Links sortierten Untergruppen, aber diesmal bezueglich der Linkfrequenz:

Dito; deswegen ganz schnell und als Letztes die nach der Anzahl der Zitate (von anderen Seiten) sortierten Untergruppen (auch bezueglich der Linkfrequenz):

Ist ja auch mal schøn, wenn man nicht so viel erklaeren und schreiben muss.

Und das war der letzte Artikel mit frischen Resultaten in dieser Maxiserie, von der ich urspruenglich dachte, dass sie nur sechs Beitrage lang wird. So sehr kann man sich verschaetzen … aber apropos Schaetze: ich wusste ja vorher nicht, was fuer Wissens- und Erkentnissschaetze mich im Linknetzwerk der Wikipedia erwarteten. Ich denke, dass da sogar noch mehr zu holen ist … aber nicht mehr von mir, das kan jetzt wer anderes machen.

Ganz am Ende bin ich aber noch nicht mit Kevin Bacon … es folgt noch ein Artikel in dem ich die Reproduktion aus einer Metaperspektive kommentiere, ein Artikel der sich die „Metastatistik“ mal anschaut und ein Abschluss … oder vielmehr zwei, die bleiben aber beide noch geheim.

Ich hatte mehr als ein Mal (bspw. hier) erwaehnt, dass es ein URST KNAPPES Ding war, dass es uns heute gibt und dass ich das an anderer Stelle mal genauer erklaeren werde.

Genauer gesagt geht es im die primordiale Nukleosynthese (enthaelt Spoiler) und das hier ist endlich besagte „andere Stelle“. Aber bevor’s richtig losgehen kann, muessen zunaechst ein paar Grundlagen aus dem Himmel fallen; ich befuerchte das geht nicht anders.

Am Anfang war das Universum urst heisz. „Heisz“ bedeutet in dem Zusammenhang, dass die sich im Universum befindenden Teilchen krass viel Energie hatten. Oder anders: die Teilchen waren so schnell, dass sie nicht lange genug beisammen blieben um gebundene Zustaende zu bilden. Und letzteres ist der Kern der Sache (tihihi … Wortspielkasse … wg. Atomkern und so) und um was es bei der Nukleo(da war er wieder, der Kern)synthese geht.
Zeitlich gesehen ist zum Anfang der hier betrachteten Prozesse das Universum noch deutlich weniger als eine Sekunde alt und die Temperatur (als Maszstab fuer die Energie … was sich in der Einheit wiederspiegelt) betrug VIELE Megaelektronenvolt (MeV) … ein eV entspricht so ca. 10-tausend Kelvin … wir sprechen hier also davon, dass das Universum viele Milliarden, vermutlich Billionen Grad Celsisus (was in dem Bereich das Gleiche ist wie Kelvin) heisz ist. Dabei kann ich gleich erwaehnen, dass die Zahlen alle so grosz sind, dass ich mich hier wirklich nicht mit Kleinigkeiten aufhalten muss und alle Zahlen vernuenftig gerundet werden; das Resultat aendert sich in der vereinfachten Darstellung hier nicht wirklich wenn man die genauen Werte benutzt … abgesehen von den Stellen wo es wichtig wird … also wenn wir in den VERDAMMT knappen Bereich gelangen.

Wichtig ist nun, dass das Universum bereits alt (und damit KALT) genug ist, dass es Neutronen und Protonen gibt. Das sind naemlich AUCH gebundene Zustaende, aber die Temperatur (Energie) der Teilchen aus denen diese wiederum bestehen (up- und down-Quarks) ist so klein, dass die nicht sofort nach einem Treffen wieder auseinander fliegen. Gleichzeitig befinden sich im Universum jede Menge Elektronen und Positronen (die sog. Antiteilchen der Ersteren) und auch Neutrinos (und deren Antiteilchen … wobei die vllt. ihre eigenen Antiteilchen sind, aber das wuerde hier zu weit fuehren und gehørt auch so ueberhaupt nicht zum Thema). Das Wunderbare ist nun, dass die sich alle gegenseitig ineinander umwandeln (WENN die Energie (also die Temperatur) grosz genug ist).

Wenn ein Neutron und ein Neutrino mit genuegend Energie aufeinander treffen, dann (hier bitte quantenfeldtheoretische Magie Mathematik einfuegen) „reagieren“ die miteinander. Am Ende gibt’s das Neutrino und das Neutron nicht mehr, dafuer aber ein Proton und ein Elektron. Fetzig wa! Der Prozess laeuft auch in die andere Richtung ab, aus einem Proton und einem Elektron werden ein Neutrino und ein Neutron. Fuer die Antiteilchen: dito (mutatis mutandis).

Weil die Energie ALLER Teilchen nun aber so gigantisch grosz ist bedeutet das, dass sich alle involvierten Teilchen im Gleichgewicht befinden. Anders ausgedrueckt: die wandeln sich staendig eineinander um. Und weil die sich staendig einander umwandeln … Achtung! jetzt kommt was Wichtiges … werden die involvierten Protonen und Neutronen einfach nicht alt, die werden ja immerzu frisch „geboren“, um sofort wieder zu „sterben“.

Weil uns die Werte einiger wichtiger Parameter fehlen kønnen wir zwar nicht die Anzahl der Protonen und Neutronen berechnen (fuer Atomkerne, unser eigenltiches Interesse, sind nur die wichtig), aber, der Thermodynamik sei Dank, ist es møglich das Verhaeltniss dieser beiden Anzahlen zu berechnen. An dieser Stelle bleibe ich einen Link und weiterfuehrende Erklaerungen diesbezueglich schuldig … wie gesagt, ein paar Sachen muessen fuer diesen Beitrag einfach vom Himmel fallen. Wieauchimmer, so lange wie das oben erwaehnte Gleichgewicht erhalten bleibt kann besagtes Verhaeltniss aus der Temperatur berechnet werden:

Achtung: eigentlich steht da vor der Temperatur noch die Boltzmannkonstante (damit das mit den Energieeinheiten hinhaut), und bei den Berechnungen weiter unten ist die auch immer mit beruecksichtigt, aber es geht hier ja um’s Verstehen des grundlegenden Prinzips und deswegen lasse ich solchen Schnapperdulli weg. Auch die 1.3 MeV kommen natuerlich irgendwo her … dito.

Bei sehr hohen  Temperaturen geht der Exponent gegen null, es gibt also gleich viele Protonen wie Neutronen. Je kaelter das Universum aber wird, umso weniger Neutronen liegen im Vergleich zur Anzahl der Protonen vor. ABER … zum Glueck fuer uns, …

… geht dieser exponentielle Abfall nicht bis ins Unendliche weiter. Der Grund ist, dass die Temperatur mit zunehmendem Alter des Universums abnimmt. Ab einer gewissen Kaelte haben die Teilchen aber nicht mehr genuegend Energie in den oben genannten Reaktionen, um die jeweils anderen Teilchen zu produzieren. Es entstehen also keine neuen Neutronen mehr und die vorhandenen werden nicht mehr in „Rueckwaertsreaktionen“ verbraucht. Somit kommt es zu einem „Ausfrieren“ derselben.
Man kann ausrechnen bei welcher Temperatur das passiert, aber ich ziehe das wieder nur aus meinem magischen Hut (in dem die ganze Thermodynamik stattfindet) und sage einfach, dass das bei ungefaehr 0.8 MeV der Fall ist. Wenn man das in die obige Formel einsetzt, erhaelt man fur das Verhaeltniss der Neutronen zu den Protonen einen Wert von 1/5. Ab dem Zeitpunkt ab dem keine neuen Neutronen mehr am laufenden Band produziert werden, kommen auf jedes Neutron fuenf Protonen. Man kann weiterhin berechnen wie alt das Universum war zum Zeitpunkt des Ausfrierens der Neutronen; ich schmeisze es and dieser Stelle dem Publikum der Zaubershow wieder nur vor die Fuesze: das Universum war ungefaehr zwei Sekunden alt, als das oben erwaehnte Gleichgewicht zusammenbrach.

Nun ist euch, meinen lieben Leserinnen und Lesern, sich aufgefallen, dass ich nur bzgl. der Neutronen erwaehnte, dass die ausfrieren. Denn Neutronen sind nicht stabil und Dank des, im ganz am Anfang des Beitrag verlinkten Artikel bereits ausfuehrlich erklaerten, Betazerfalls kønnen Protonen weiterhin produziert werden. Naemlich indem Neutronen in Protonen und Elekronen (und Antineutrinos) zerfallen. Das geht dann natuerlich nach der wohlbekannten Formel (hier den Gegebenheiten etwas angepasst):

Die (durchschnittliche) Neutronenzerfallszeit … ACHTUNG: die durchschnittliche Zerfallszeit ist nicht zu verwechseln mit der bekannteren Halbwertszeit; Erstere muss mit dem natuerlichen Logarithmus von zwei multipliziert werden, um Letztere zu erhalten … Letztere ist aber intuitiver, einfach weil man es sich leichter vorstellen kann, wann die Haelfte von irgendwas nicht mehr da ist … aber ich schwoff ab und wollte sagen, dass die Konstante im Exponenten ca. 880 Sekunden betraegt.

Oder anders: Als das Universum zwei Sekunden alt wurde begann die Uhr maechtig schnell zu ticken … und damit sind wir auch mittendrin im eigentlichen Thema … und ich merke, dass das laenger dauert als gedacht, weswegen ich das an anderer Stelle fortsetzen werde.